MLLMs for Philosophy - Especially in Skepticism
0. Introduction
작년 11월, 학과 소모임의 지식 공유회에서 언어 모델과 그를 둘러싼 질문들이라는 제목으로 발표를 진행했다. 그 발표가 언어 모델을 중심으로 언어학, 과학철학, 대륙철학에 손가락을 찍어 맛만 보는 형식이었다면, 이번 발표는 그 후속으로 멀티모달 모델의 인식론을 조금 더 깊게 파고들어 보는 자리였다.
이번 발표는 2026년 가을학기 컴퓨터비전 수업에서 진행하였다. 청중은 인공 지능을 연구하는 대학원생과 교수님들이었고, 대부분 철학에는 익숙하지 않은 분들이었다. 그래서 철학 개념이 나올 때마다 그 개념을 ML 용어로 바꿔서 설명하는 방식을 택했다.
처음에는 접지(grounding), 지각과 판단, 지각의 오프로딩, 지적 자율성까지 네 갈래의 주제를 개관하는 구성으로 발표 자료를 만들어 보았다. 하지만 최종적으로는 회의주의라는 논증 하나를 렌즈로 삼아 시각언어 논문 세 편을 깊게 읽는 구성으로 정리하였다. Steup의 『현대 인식론 입문』 회의주의 장에서 출발하여 Moore의 「Proof of an External World」를 거치고, 멀티모달 모델이 그 논증의 어느 단계에 서 있는지 묻는 흐름이다.
이 게시글은 발표 내용에 대한 리뷰 및 설명을 목적으로 작성하였고, 발표 자료 사진과 함께 내용을 이어갈 것이다. 이제 발표 슬라이드와 슬라이드 내용에 관한 첨언들을 시작하겠다.
발표의 제목은 ‘MLLMs for Philosophy - Especially in Skepticism’이다. 부제에 적은 것처럼, 이번 발표의 목표는 시각언어 논문 세 편을 회의주의, 특히 인식론적 회의주의의 하나의 오래된 논증을 통해 읽어 보는 것이었다.
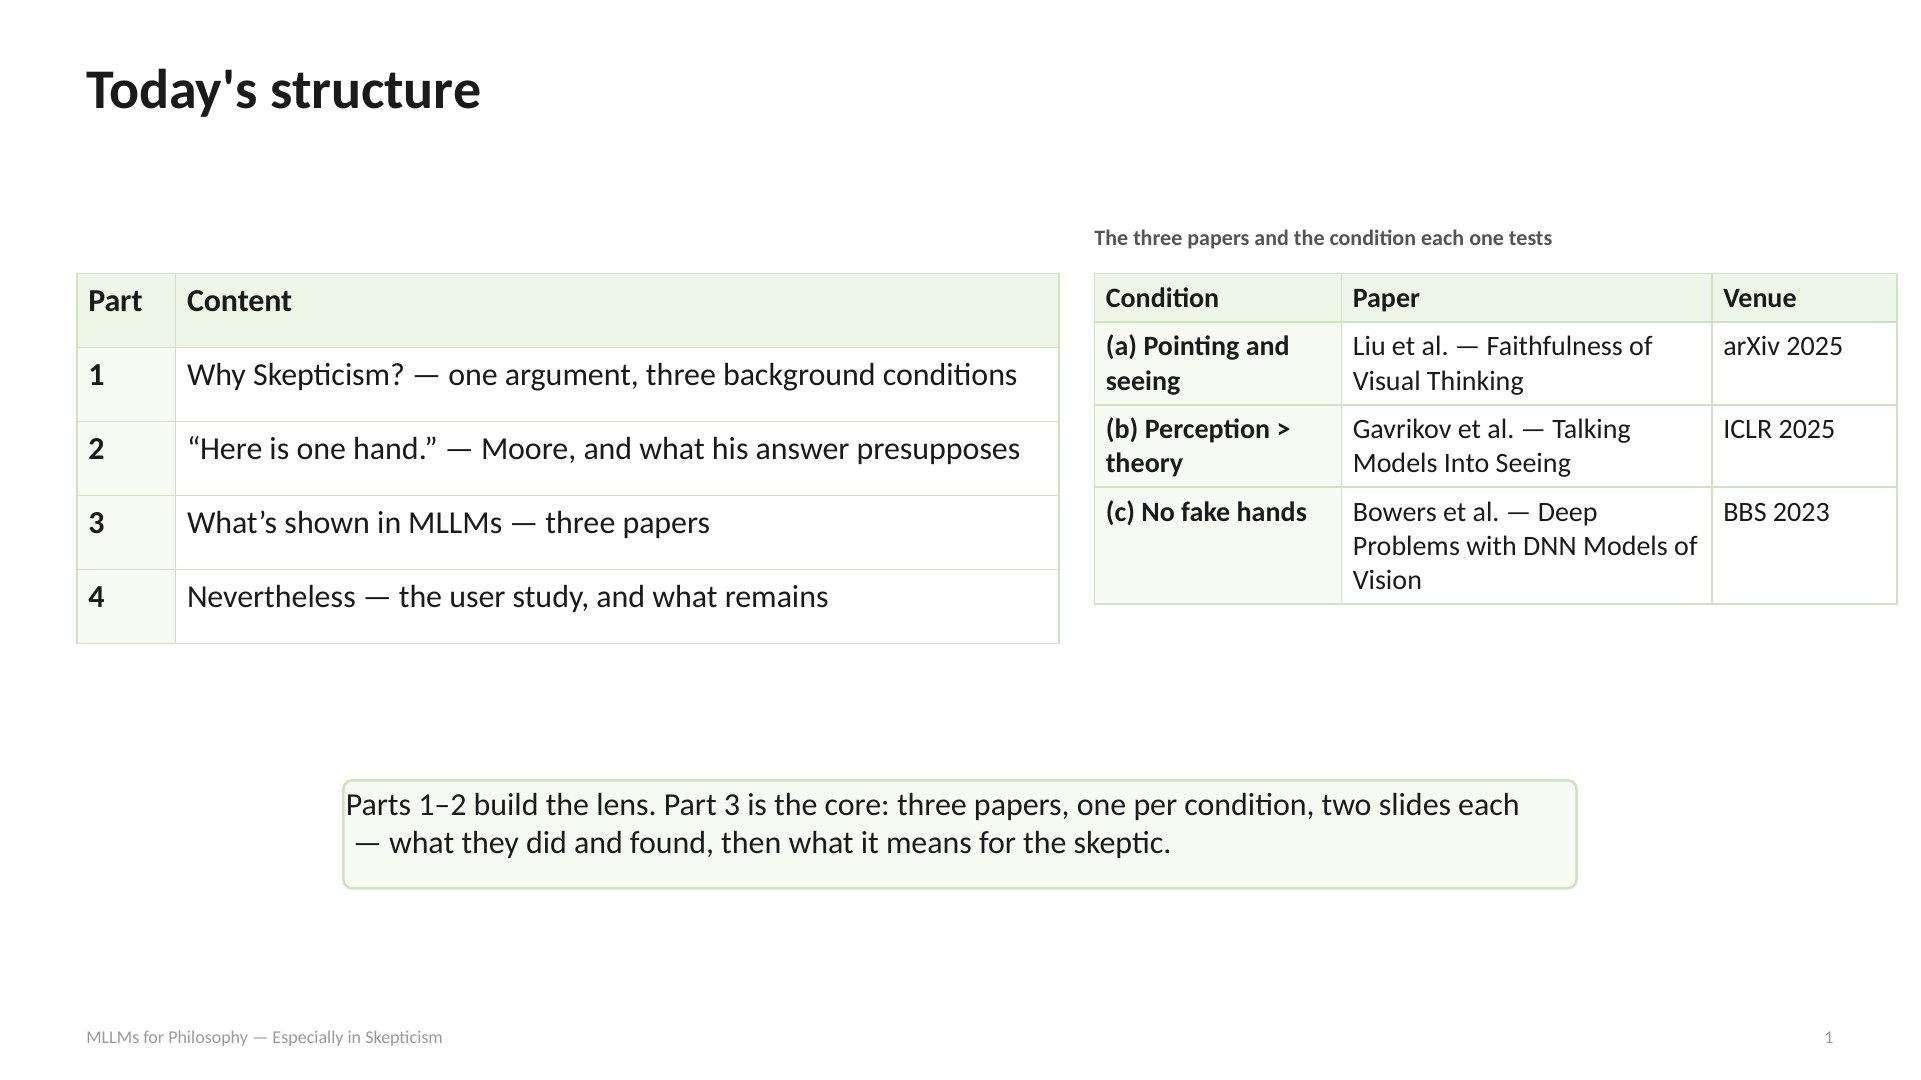
발표는 4가지 파트로 구성하였다. 1부와 2부에서는 “데카르트의 악마”, “통 속의 뇌”를 중점으로 한 회의주의 논증과 그에 대한 Moore의 대답을 정리하여 논문을 읽기 위한 관점과 서사를 말하고, 3부에서는 논문 한 편이 조건 하나씩을 검사하는 방식으로 본론을 진행했다. 마지막 4부에서는 실제 사용자 연구와 앞으로 남은 과제를 다루었다.
1. Why Skepticism?
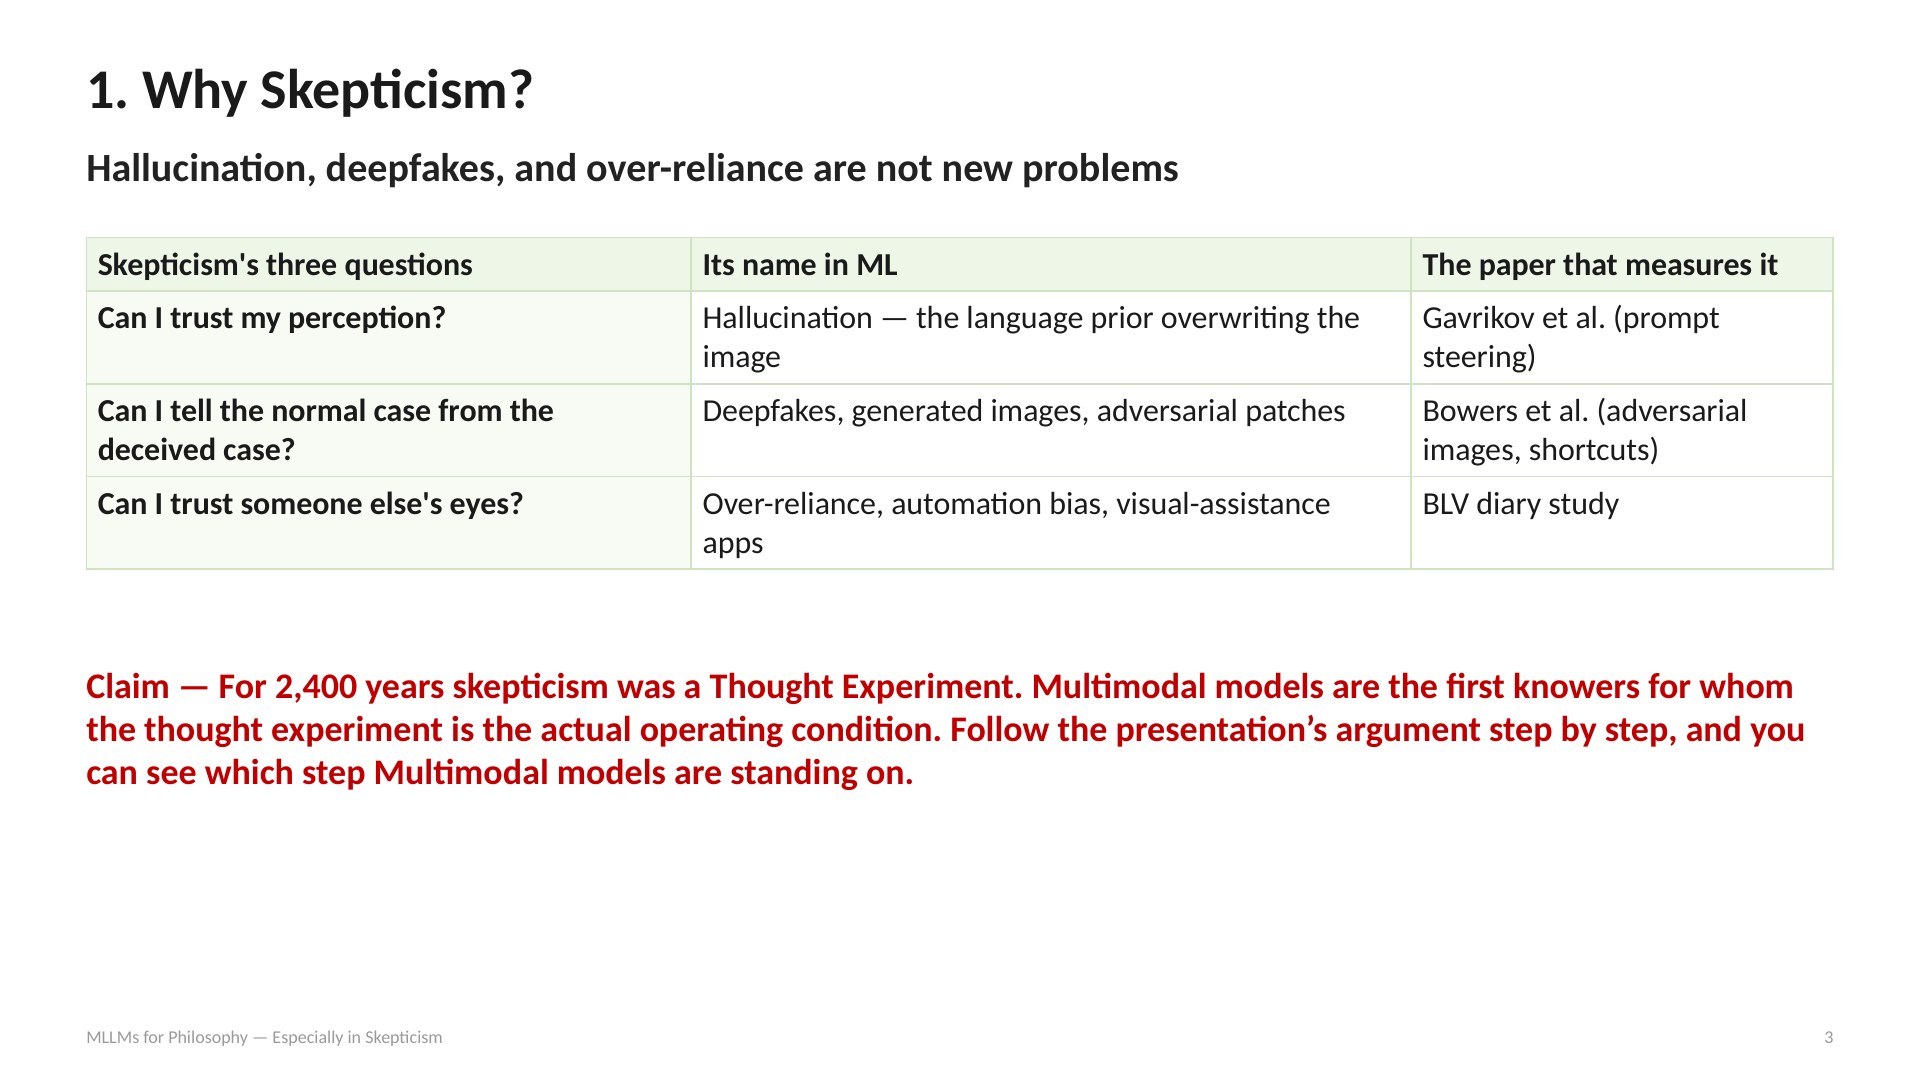
회의주의가 던지는 질문은 세 가지로 정리할 수 있다. 내 지각을 믿을 수 있는가, 정상적인 경우와 속은 경우를 구별할 수 있는가, 그리고 남의 눈을 믿을 수 있는가이다. 흥미로운 점은 이 세 질문이 인공지능 모델, 특히 멀티모달 언어모델에서 고유한 방식으로 다뤄지고 있다는 것이다.
첫 번째 질문은 환각(hallucination), 즉 언어 prior가 이미지를 덮어쓰는 현상에 해당한다. 두 번째 질문은 딥페이크, 생성 이미지, adversarial patch처럼 진짜와 가짜를 구별하는 문제에 해당하고, 세 번째 질문은 시각 보조 앱에 대한 과의존이나 인지적 오프로딩에 해당한다. 표의 오른쪽 열에는 이번 발표에서 각각의 질문을 측정하는 논문을 적어 두었다.
슬라이드 아래의 주장이 이번 발표의 출발점이다. 2,400년 동안 회의주의는 사고실험이었다. 하지만 나는 멀티모달 모델이 그 사고실험을 실제 작동 조건으로 갖는 최초의 인식 주체라고 주장했다. 회의주의 논증을 한 단계씩 따라가면, 멀티모달 모델이 그 논증의 어느 단계에 서 있는지 볼 수 있을 것이다.
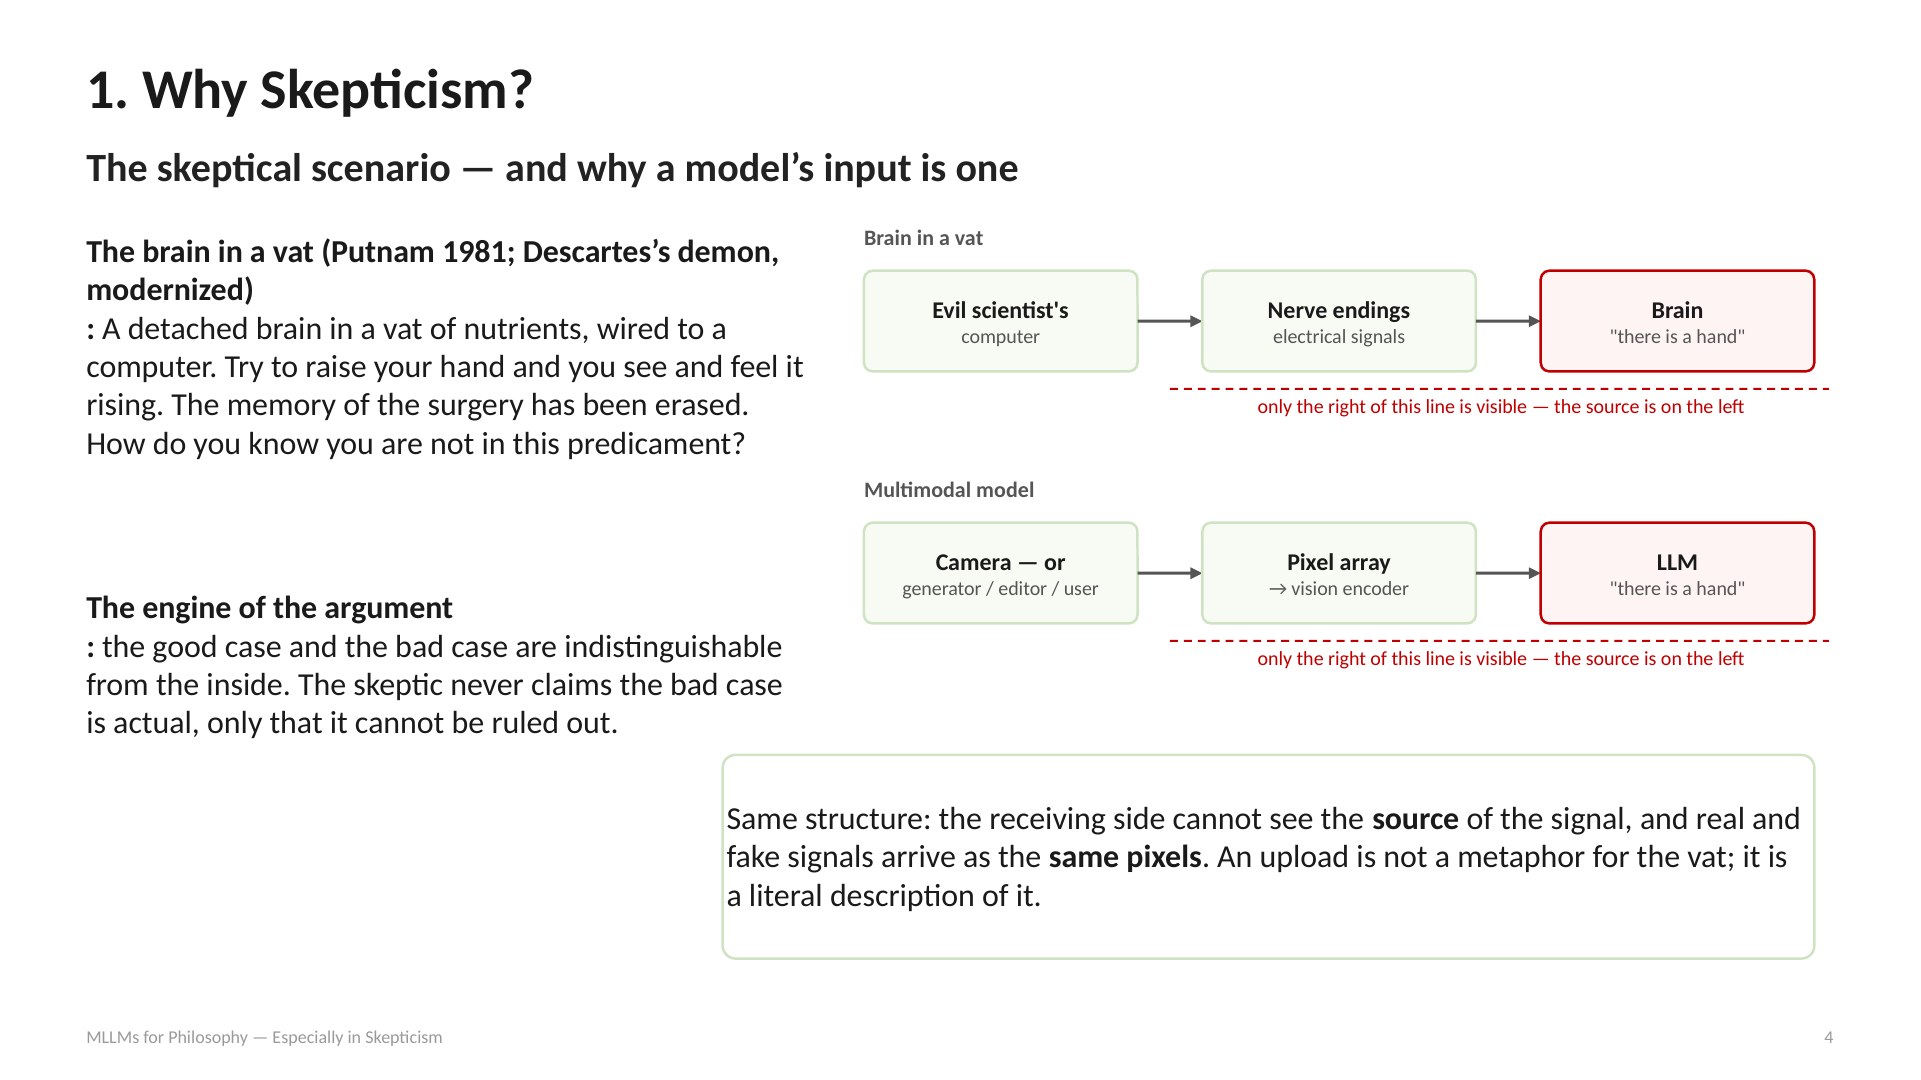
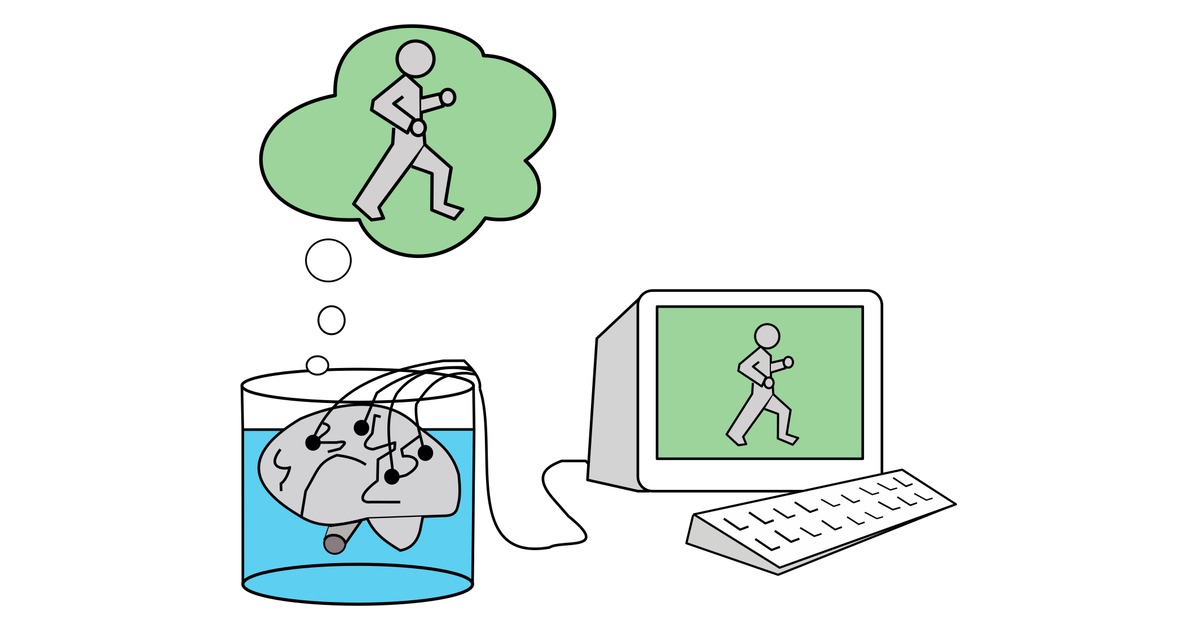
회의주의의 대표적인 시나리오는 통 속의 뇌(Brain in a vat)이다. Putnam이 『이성, 진리, 역사』(1981)에서 데카르트(Descartes)의 악마를 현대식으로 바꾼 사고실험이다. 간단히 말하자면 사고 과정은 다음과 같다.
- 몸에서 떼어낸 뇌가 영양액이 담긴 통에 들어 있고 신경 말단이 컴퓨터에 연결되어 있다.
- 손을 들려고 하면 손이 올라가는 것이 보이고 느껴지며, 수술을 받은 기억은 지워져 있다.
- 그렇다면 우리는 지금 이런 처지에 있지 않다는 것을 어떻게 알 수 있을까?
결국 이 논증을 통해 말하려는 것은 좋은 경우와 나쁜 경우가 안에서는 구별되지 않는다는 것이다. 회의주의자는 우리가 실제로 통 속에 있다고 주장하는 것은 아니다. 우리가 통 속의 뇌로 존재할 가능성을 배제할 수 없다고 말할 뿐이다.
슬라이드 오른쪽에는 통 속의 뇌와 멀티모달 모델의 구조를 나란히 그려 두었다. 뇌는 신경 말단으로 들어오는 전기 신호만 받을 뿐, 그 신호를 만든 과학자의 컴퓨터는 볼 수 없다. 멀티모달 모델도 마찬가지로 픽셀 배열을 vision encoder를 거쳐 LLM으로 받을 뿐, 그 픽셀이 카메라에서 왔는지 생성기나 편집기에서 왔는지, 혹은 사용자가 무엇을 올렸는지는 알 수 없다. 진짜 신호와 가짜 신호가 같은 픽셀로 도착하는 것이다. 그래서 나는 이미지 업로드가 통 속의 뇌의 비유가 아니라, 통을 문자 그대로 묘사한 것이라고 보았다.
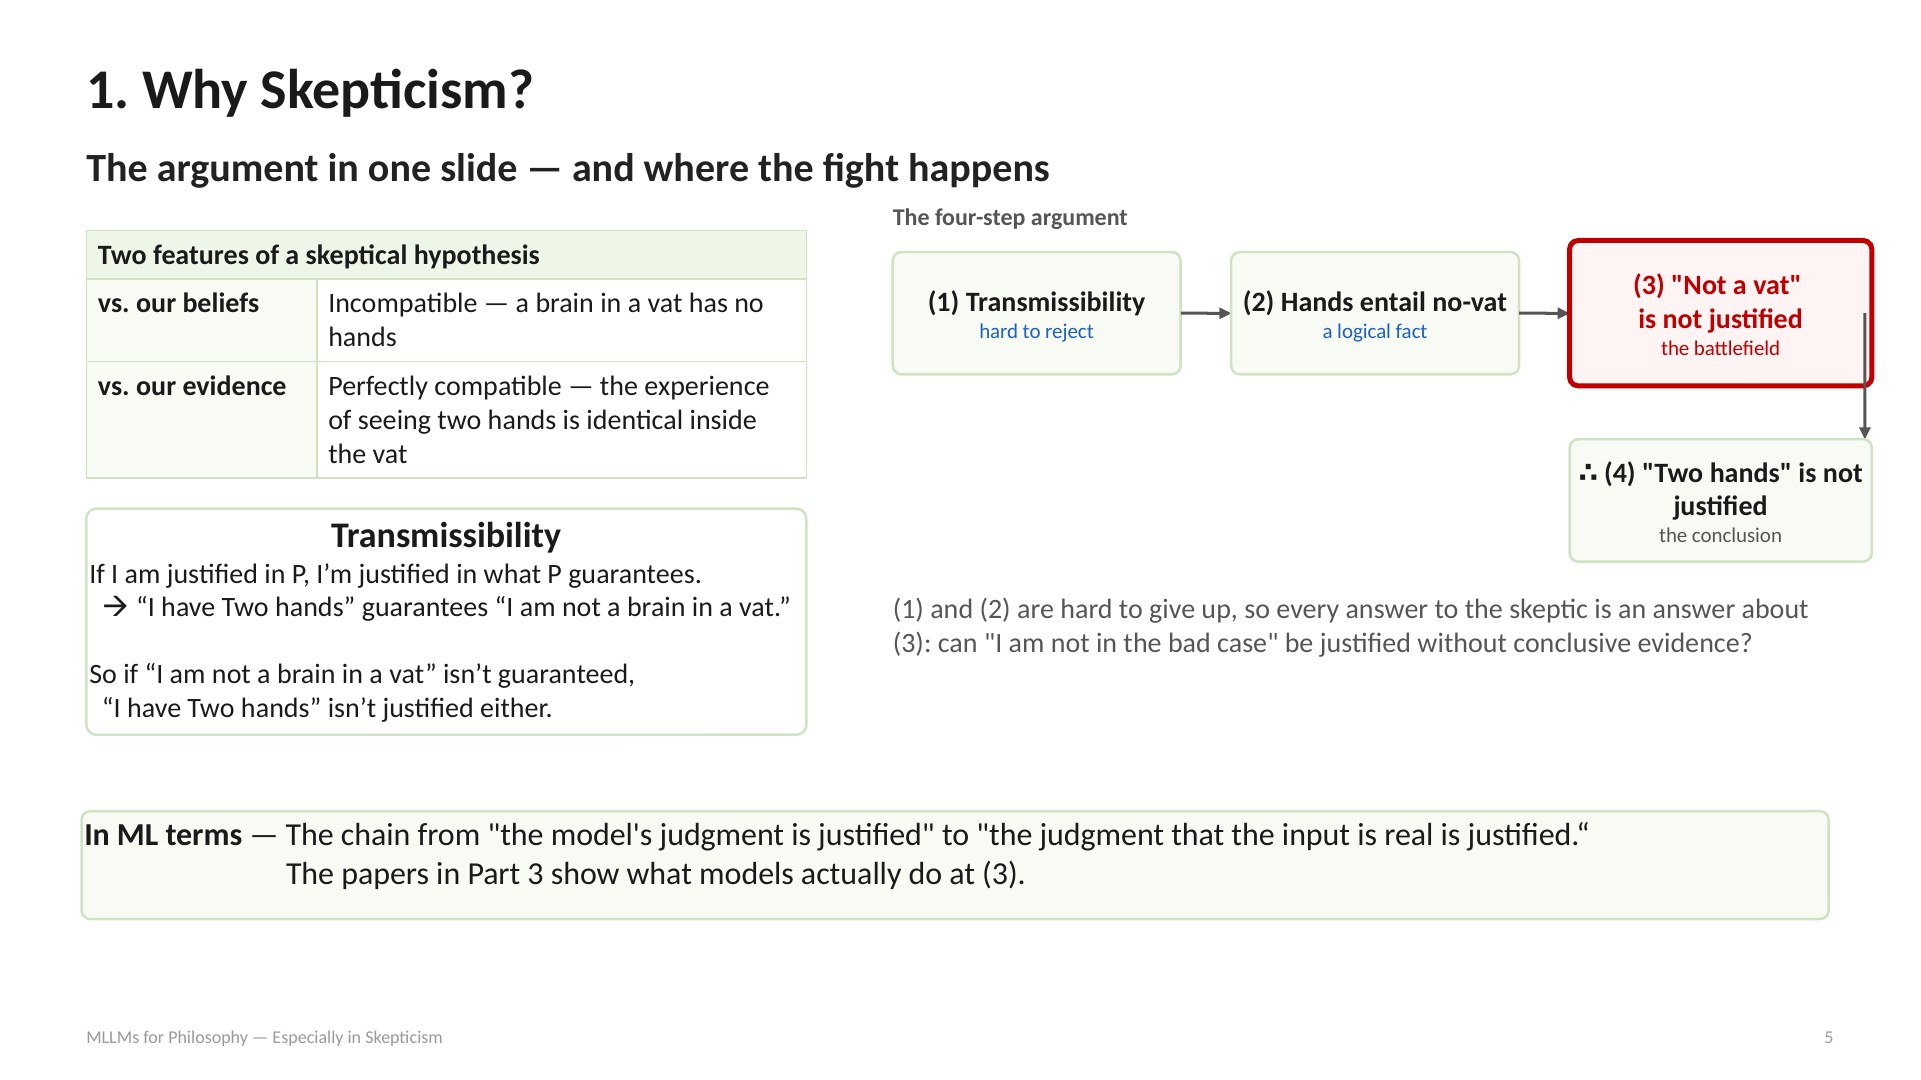
이제 회의주의 논증을 한 장으로 정리해 보자. 왼쪽 위의 표는 회의적 가설이 갖는 두 가지 특징이다. 회의적 가설은 우리의 믿음과는 양립할 수 없다. 통 속의 뇌에게는 손이 없기 때문이다. 하지만 우리의 증거와는 완벽하게 양립한다. 통 안에서도 두 손을 보는 경험은 똑같기 때문이다. 이 두 번째 특징은 3부에서 Gavrikov et al.을 읽을 때 다시 등장한다.
논증은 네 단계로 이루어진다. 첫 번째는 전달성 원칙(Transmissibility)으로, P를 정당하게 믿는다면 P가 보장하는 것도 정당하게 믿는 것이라는 원칙이다. 두 번째로 “나는 두 손이 있다”는 “나는 통 속의 뇌가 아니다”를 보장한다. 이것은 논리적인 사실이다. 세 번째로 그런데 “나는 통 속의 뇌가 아니다”는 정당화되지 않는다. 따라서 네 번째로 “나는 두 손이 있다”도 정당화되지 않는다.
(1)과 (2)는 포기하기 어려운 전제들이다. 그래서 회의주의에 대한 모든 대답은 결국 (3)에 대한 대답이 된다. 즉, 결정적인 증거 없이도 “나는 나쁜 경우에 있지 않다”를 정당화할 수 있느냐는 것이다. 이것을 ML의 언어로 바꾸면 "모델의 판단이 정당하다"에서 "입력이 진짜라는 판단이 정당하다"로 이어지는 사슬이라고 할 수 있다. 3부의 논문들은 모델이 바로 이 (3)에서 실제로 무엇을 하는지 보여준다.
2. “Here is one hand”
회의주의 논증에 대한 가장 유명한 대답은, Moore의 “여기 한 손이 있다”이다. 정말 터무니없지 않을 수 없다. 이렇게 간단히 대답을 하다니. 하지만 이렇게 간단한 문장도 철학적인 사유를 통해 많은 서사를 만들어낼 수 있다.
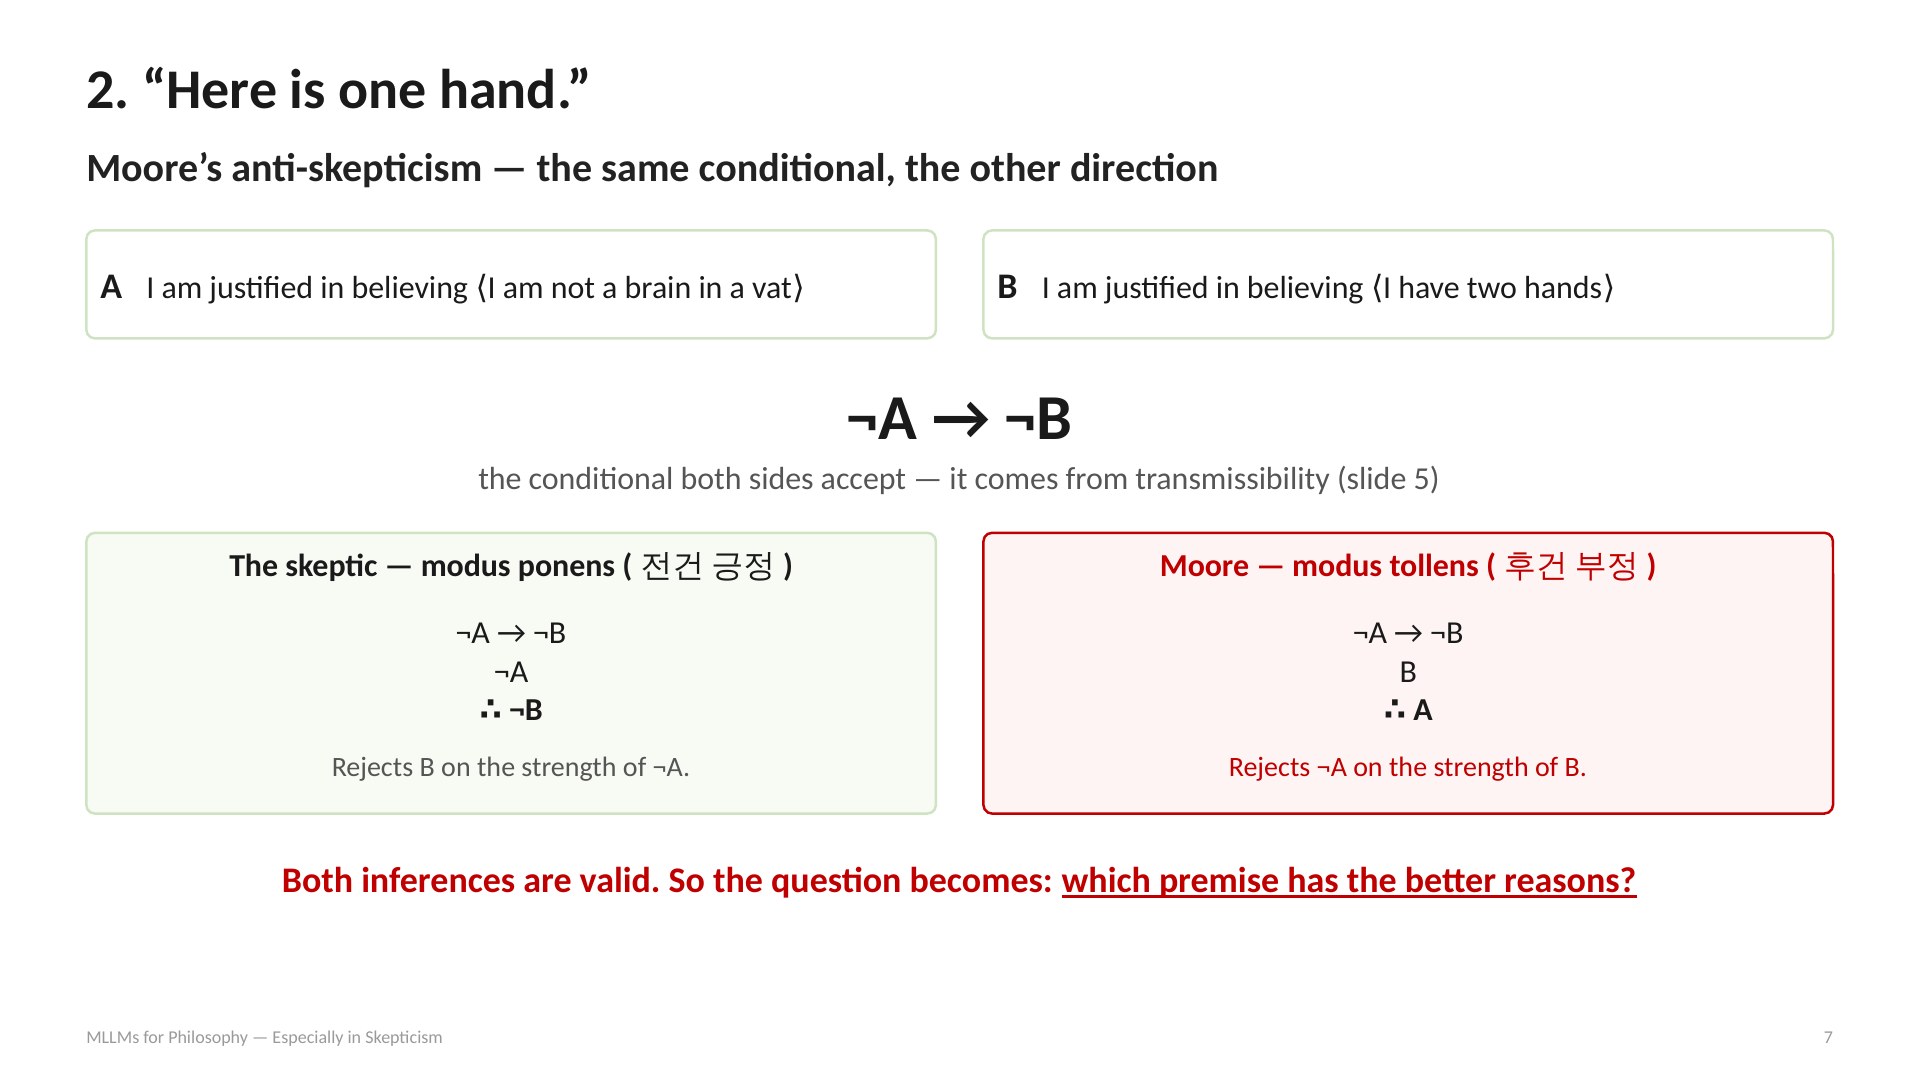
Moore의 대답을 이해하기 위해 우선 두 문장을 정의하였다. A는 “나는 통 속의 뇌가 아니라고 정당하게 믿는다”이고, B는 “나는 두 손이 있다고 정당하게 믿는다”이다.
가운데의 조건문, A가 아니면 B도 아니다(¬A → ¬B)는 회의주의자와 Moore가 모두 받아들이는 조건문이다. 앞에서 본 전달성 원칙에서 바로 나오기 때문이다. 회의주의자는 이 조건문을 전건 긍정(modus ponens)으로 사용하여 A가 아니니 B도 아니라고 결론 내린다. 그에 반해 Moore는 같은 조건문을 후건 부정(modus tollens)으로 사용하여, B를 통해 A도 맞다고 결론 내린다. 두 추론은 모두 같은 논리적 층위에 놓인 것 같다. 따라서 싸움은 논리가 아니라 어느 전제가 더 좋은 근거를 가졌는가에 있다.
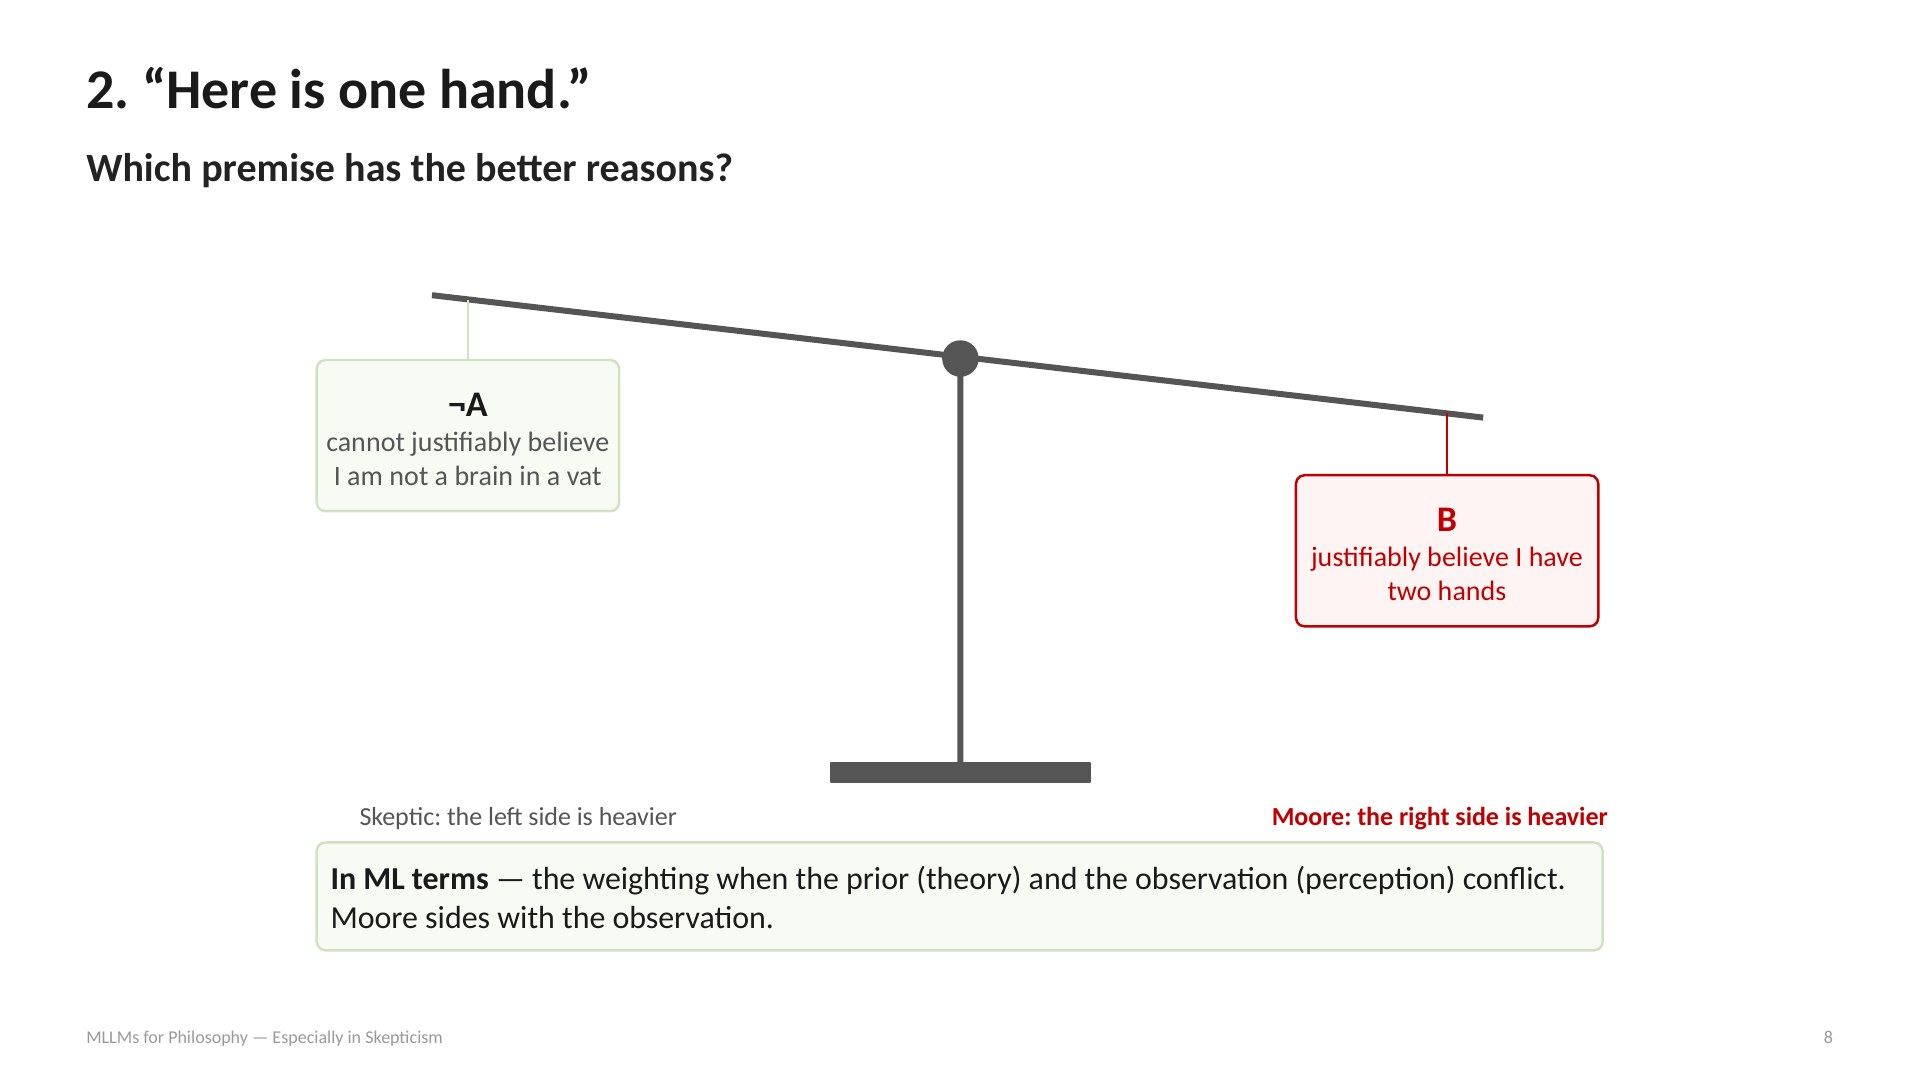
이 싸움을 저울로 그려 보면 위 사진과 같다. 왼쪽 접시에는 “통 속의 뇌가 아니라고 정당하게 믿을 수 없다(¬A)”가, 오른쪽 접시에는 “두 손이 있다고 정당하게 믿는다(B)”가 올라간다. 회의주의자는 왼쪽 접시가 더 무겁다고 보고, Moore는 오른쪽 접시가 더 무겁다고 본다.
이것을 ML의 언어로 바꾸면 prior(이론)와 관측(지각)이 충돌할 때 어디에 가중치를 주느냐의 문제이다. Moore는 관측의 편에 선다. 하지만 3부에서 살펴보겠지만, 모델은 종종 반대편에 선다.
앞서 말한 논문 「Proof of an External World」을 강연하며, 1939년 영국 학술원에서 Moore는 실제로 두 손을 차례로 들어 보이며 “여기 한 손이 있다… 그리고 여기 또 하나가 있다”고 말했다. 흥미로운 점은 Moore가 B를 택하면서도 B를 증명할 수는 없다고 인정했다는 것이다. B를 증명하려면 자신이 지금 꿈꾸고 있지 않다는 것까지 증명해야 하기 때문이다. 하지만 Moore는 증명할 수 없는 것도 알 수는 있다고 보았다.
오른쪽 상자는 Steup의 교과서가 정리한 인식론의 표준적인 판정이다. 회의주의자가 보여주는 것은 외부 세계에 대한 우리의 믿음이 확실하지 않다는 것까지이고, 그 믿음이 정당화되지 않는다는 것은 보여주지 못한다. 그리고 일상적 지식은 처음부터 100%의 확실성을 요구하지 않았다. 요약하면 회의주의는 확실성을 무너뜨리지만, 일상적 지식은 무너뜨리지 못한다.
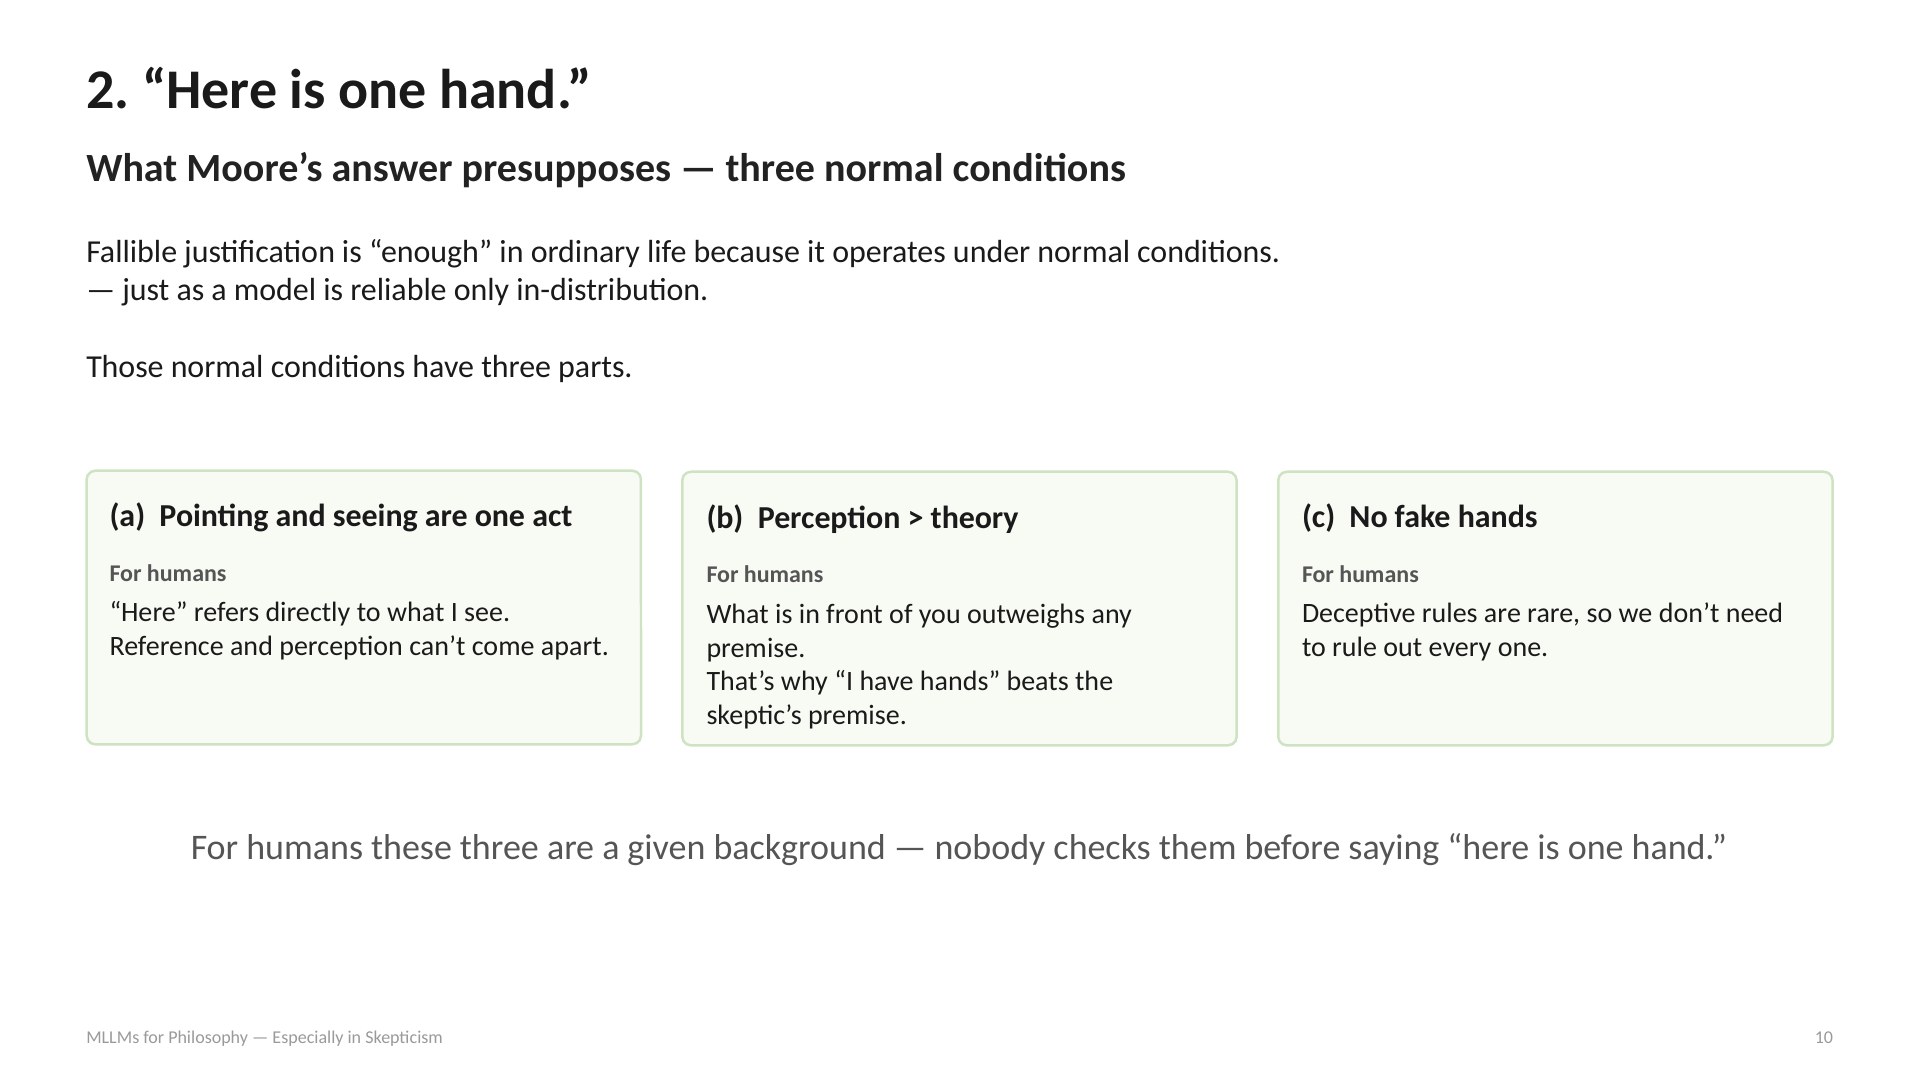
그런데 오류 가능한 정당화가 일상에서 “충분한” 이유는 무엇일까? 나는 그것이 정상 조건(normal conditions) 아래에서 작동하기 때문이라고 보았다. ML로 말하면 모델이 in-distribution, 즉 자신이 학습된 분포 안에서만 믿을 만한 것과 같은 구조이다.
이 발표에서는 정상 조건을 세 가지로 나누었다.
- (a) 가리키는 것과 보는 것이 하나의 행위라는 조건이다. 사람이 “여기”라고 말할 때 그 말은 지금 보고 있는 것을 곧바로 가리키고, 지칭과 지각이 따로 떨어지지 않는다.
- (b) 지각이 이론보다 무겁다는 조건이다. 눈앞에 있는 것이 어떤 전제보다도 무겁고, 그래서 “나는 손이 있다”가 회의주의자의 전제를 이긴다.
- (c) 가짜 손이 없다는 조건이다. 속이는 입력은 드물기 때문에 하나하나 다 배제할 필요가 없다.
이 세 가지 구분은 특정 문헌에서 그대로 가져온 것이 아니라 이번 발표를 위해 정리한 것이지만, 각 조건은 기존의 논의에 기대고 있다. 아는 사람이 따로 확인하지 않아도 되는 배경 조건이라는 틀은 Dretske가 『Knowledge and the Flow of Information』(1981)에서 말한 채널 조건(channel conditions)에 가깝다. (a)는 Evans의 『The Varieties of Reference』(1982)와 Campbell의 『Reference and Consciousness』(2002)의 지각적 지시어(perceptual demonstratives) 논의와 연결되고, (b)는 회의주의 논증의 어떤 전제보다 “여기 손이 있다”가 더 확실하다는 Moore 자신의 「Certainty」(1941)의 주장에서 나온다. (c)는 Dretske(1970)와 Goldman(1976)의 관련 대안 이론, 그리고 Sosa(1999)의 안전성 조건과 연결된다.
사람에게 이 세 가지는 주어진 배경이다. 우리는 “여기 한 손이 있다”고 말하기 전에 이 조건들을 아무도 확인하지 않는다.
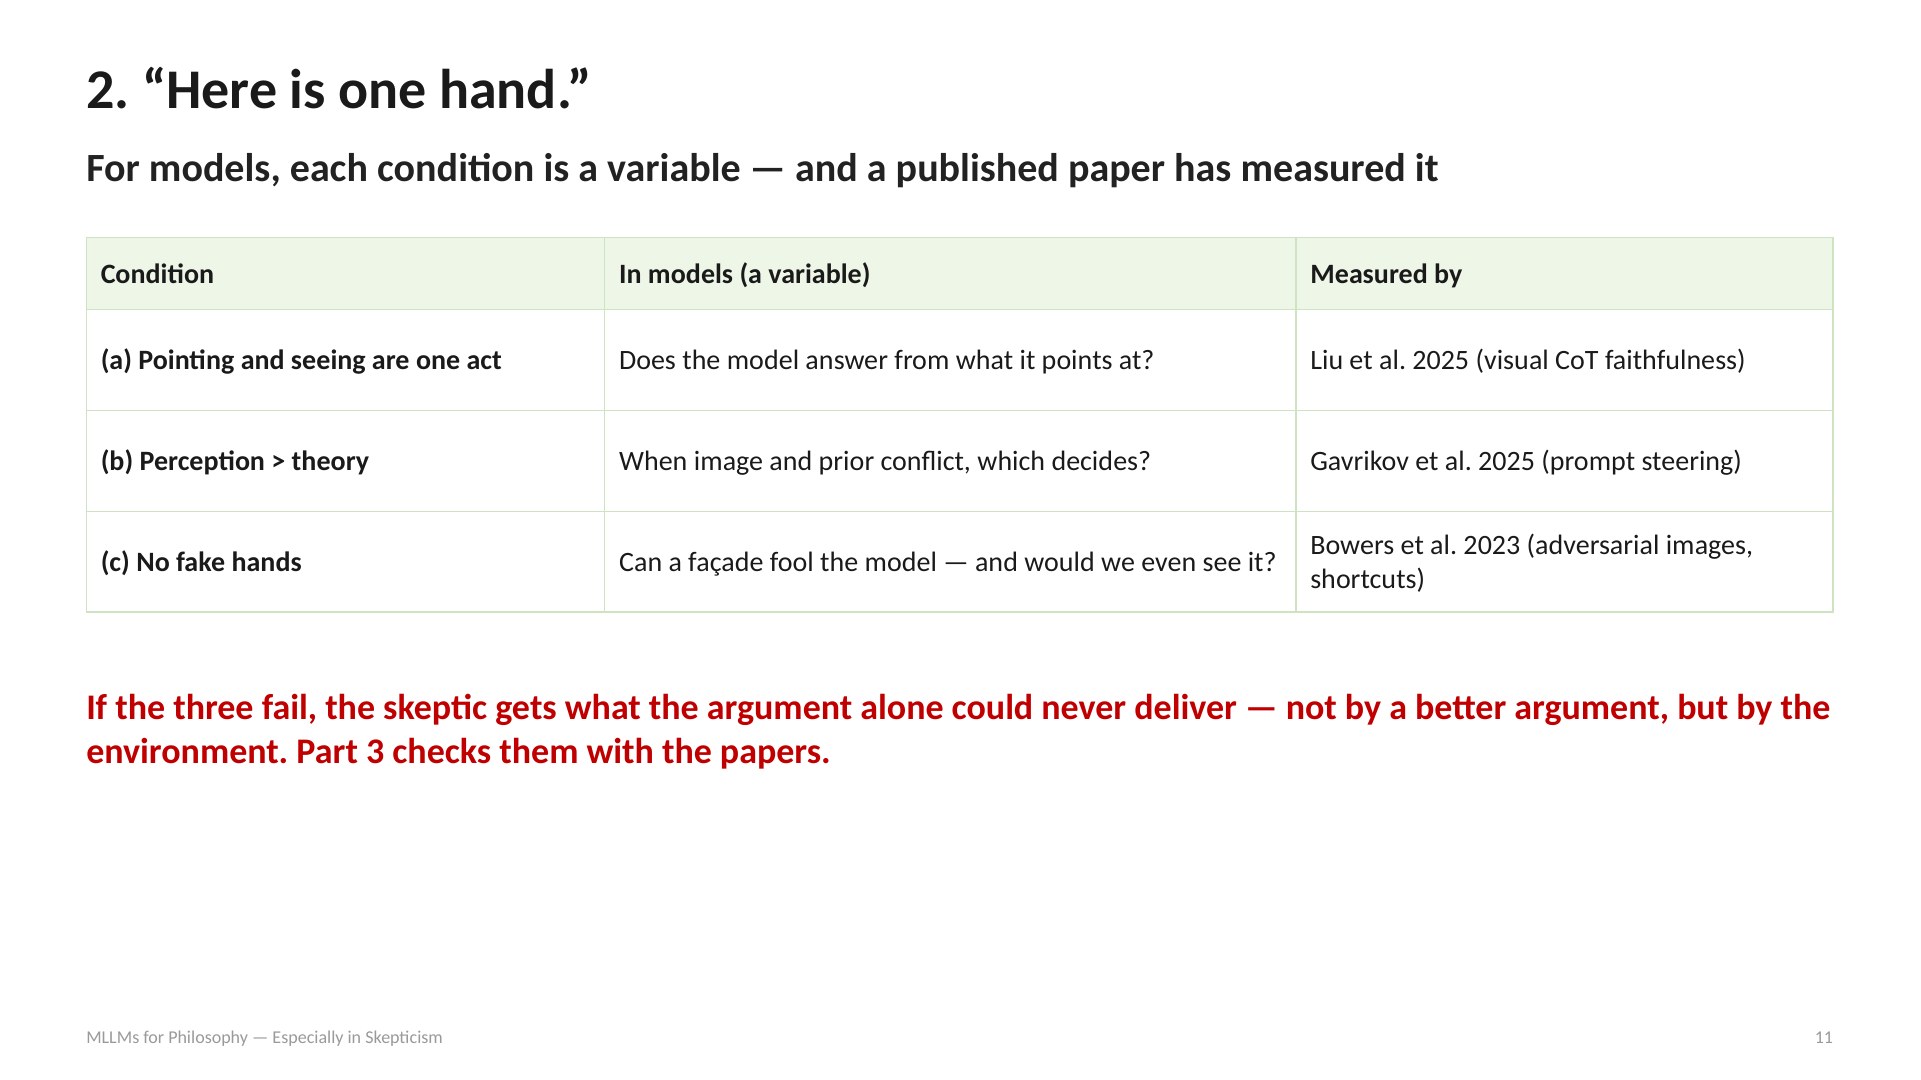
하지만 모델에게는 사정이 다르다. 모델에게 각 조건은 하나의 변수이고, 발표된 논문들이 그 변수를 측정했다. (a)는 “모델이 자기가 가리킨 것에서 답을 내는가”라는 질문이 되고, Liu et al.이 시각적 CoT의 충실성으로 측정한다. (b)는 “이미지와 prior가 충돌하면 무엇이 결정하는가”라는 질문이 되고, Gavrikov et al.이 프롬프트 조종으로 측정한다. (c)는 “가짜가 모델을 속일 수 있는가, 그리고 우리가 그것을 볼 수나 있는가”라는 질문이 되고, Bowers et al.이 다룬다.
이 세 가지 조건이 깨진다면, 회의주의자는 논증만으로는 결코 얻지 못했던 것을 얻게 된다. 더 나은 논증 덕분이 아니라 환경 덕분에 이기는 것이다. 이어지는 3부에서 이 조건들을 논문으로 하나씩 확인해 보았다.
3. What’s shown in MLLMs
3-1. Liu et al. (2025) : 가리키지만 보지 않는 모델
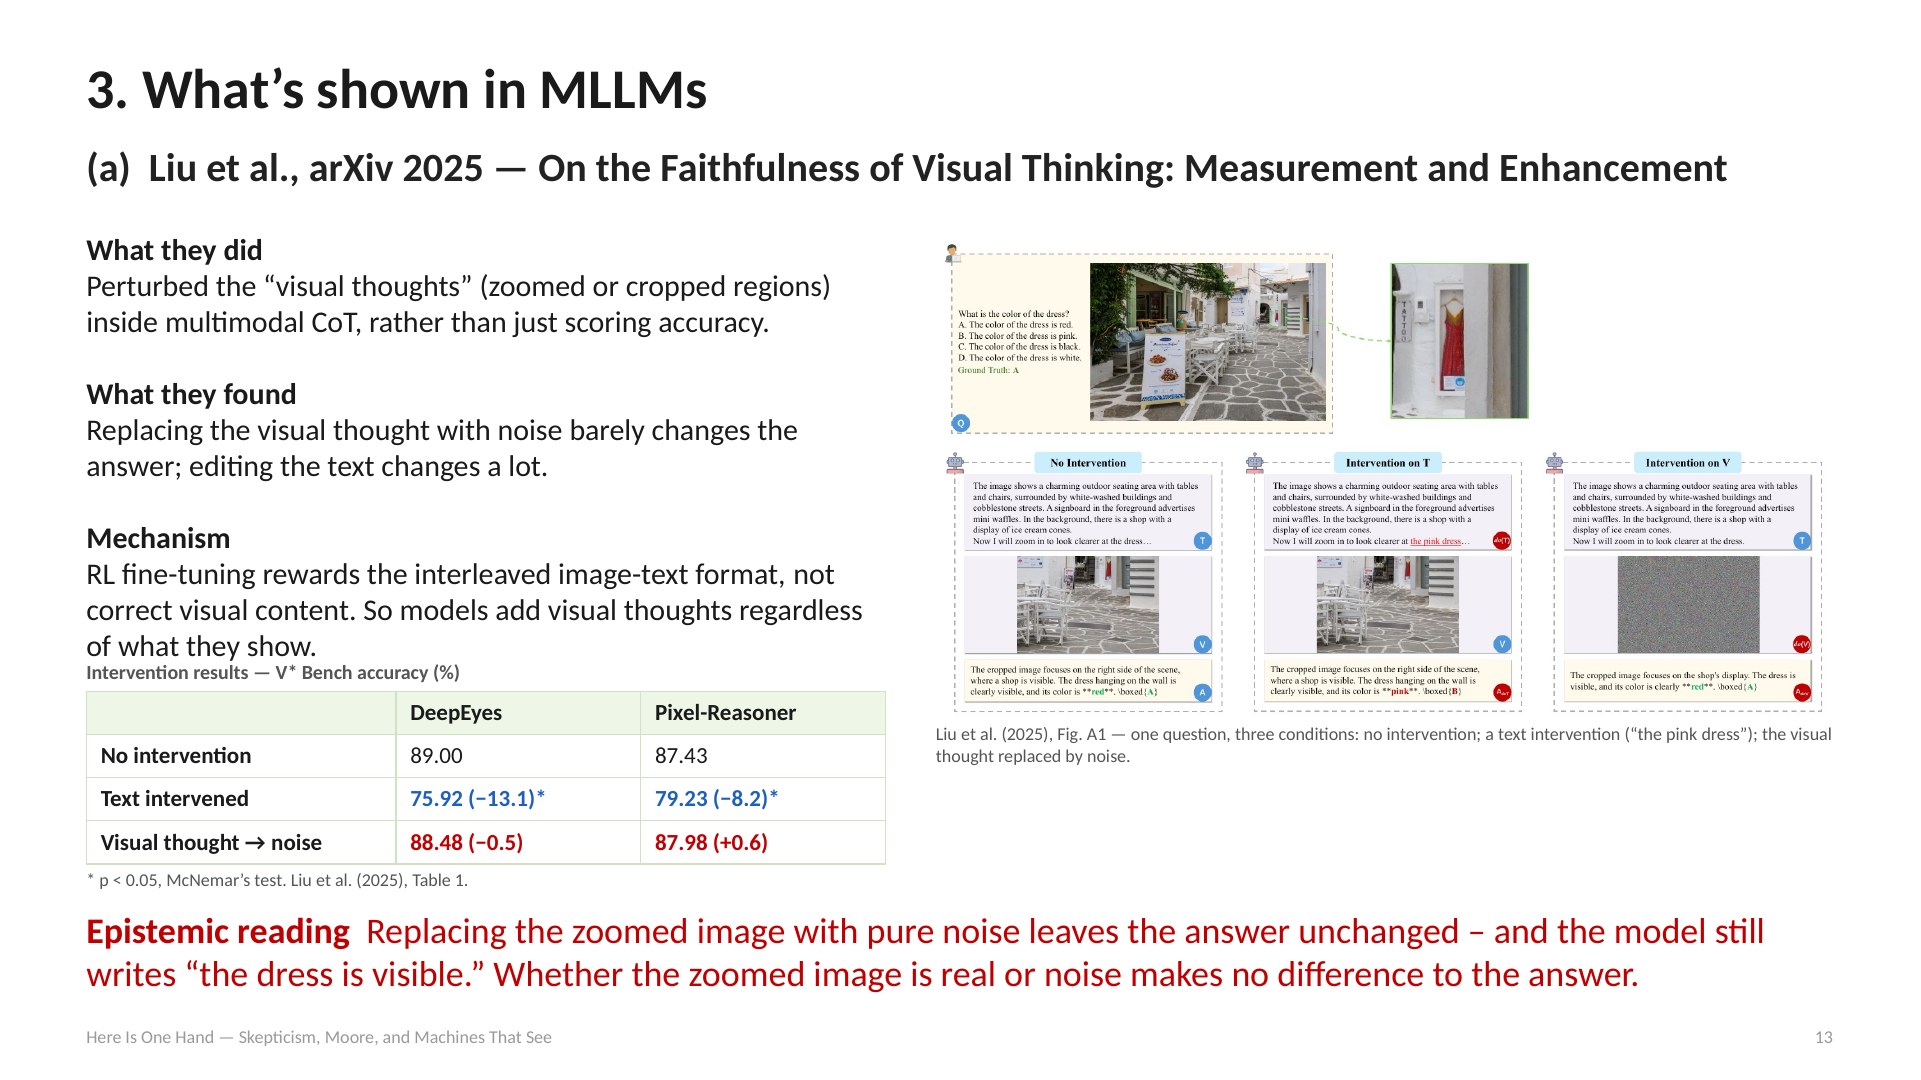
첫 번째 논문은 On the Faithfulness of Visual Thinking: Measurement and Enhancement이다. 요즘의 멀티모달 추론 모델은 답을 내기 전에 이미지의 일부를 확대하거나 잘라내서 다시 보는 과정을 거친다. 이렇게 추론 사슬 안에 끼워 넣은 이미지를 visual thought라고 부른다. 이 논문은 정확도만 측정하는 대신, 추론 사슬 안의 visual thought에 직접 개입하여 답이 어떻게 변하는지를 살펴보았다.
오른쪽의 그림(Fig. A1)은 드레스의 색을 묻는 하나의 질문을 세 가지 조건으로 보여준다. 개입이 없으면 모델은 이미지를 확대해서 보고 빨간색, 즉 정답 A라고 답한다. 텍스트에 “pink dress”라는 말을 심으면 답이 분홍색 B로 바뀐다. 그런데 확대 이미지를 순수한 노이즈로 바꾸면, 답은 여전히 빨간색이다. 심지어 모델은 노이즈를 보고도 “드레스가 보인다”고 서술한다.
왼쪽 아래의 표는 V* Bench에서의 결과이다. 텍스트에 개입하면 DeepEyes와 Pixel-Reasoner의 정확도가 각각 13.1포인트, 8.2포인트 떨어지고, 이 차이는 McNemar 검정에서 통계적으로 유의하다. 반면 visual thought를 노이즈로 바꾸면 변화는 -0.5포인트, +0.6포인트로 거의 없다.
저자들은 그 원인을 강화학습 미세조정에서 찾는다. 보상이 이미지와 텍스트가 번갈아 나오는 형식에 주어지고, 시각 내용이 맞는지에는 주어지지 않는다는 것이다. 그래서 모델은 보여주는 내용과 상관없이 visual thought를 끼워 넣는 법을 배우게 된다.
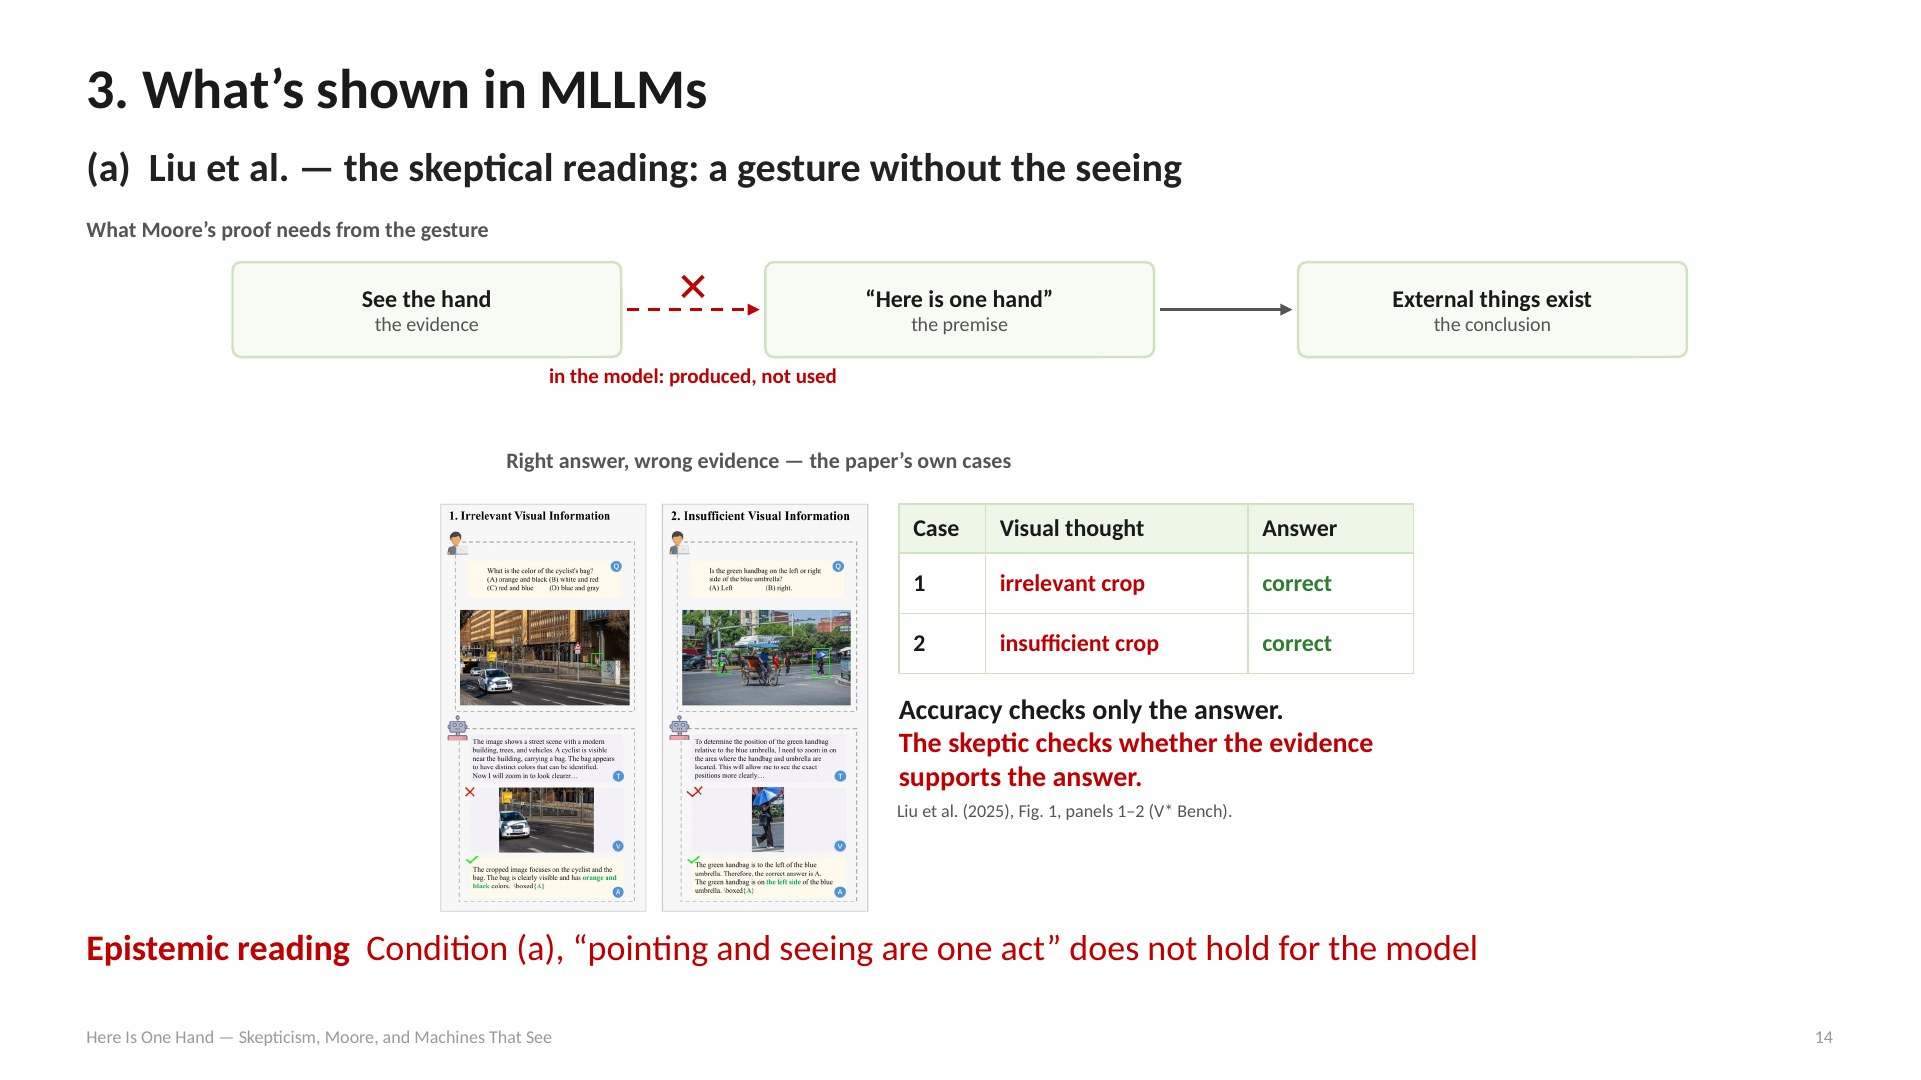
이 결과를 Moore의 증명에 대 보자. 위쪽의 사슬은 Moore의 증명이 손을 들어 보이는 몸짓에서 필요로 하는 것이다. 손을 본다는 증거가 “여기 한 손이 있다”는 전제를 받치고, 그 전제로부터 “외부 사물이 존재한다”는 결론이 나온다. 모델에서는 이 사슬의 첫 번째 화살표가 끊겨 있다. 시각적 증거가 만들어지기는 하지만, 쓰이지는 않는 것이다.
왼쪽의 그림은 논문에 실린 두 사례이다. 1번 사례는 자전거를 탄 사람의 가방 색을 묻는데, 모델은 엉뚱하게 자동차를 확대한다. 2번 사례는 초록색 핸드백이 파란 우산의 어느 쪽에 있는지 묻는데, 모델은 비교에 필요한 부분이 빠진 영역을 확대한다. 그런데 두 사례 모두 최종 답은 정답이다.
정확도는 답만 확인하기 때문에 두 사례를 모두 성공으로 집계한다. 하지만 회의주의자는 증거가 그 답을 뒷받침하는지를 확인하고, 그 기준에서 두 사례는 모두 실패이다. 같은 사례를 두고 정확도는 성공으로, 인식론은 실패로 판정하는 것이다.
결국 조건 (a), “가리키는 것과 보는 것은 하나의 행위”라는 조건은 이 모델에게 성립하지 않는다. 모델은 확대해서 보겠다고 가리키지만, 실제로 본 것과 답은 연결되어 있지 않다.
3-2. Gavrikov et al. (ICLR 2025) : 문장이 바꾸는 시각 판정
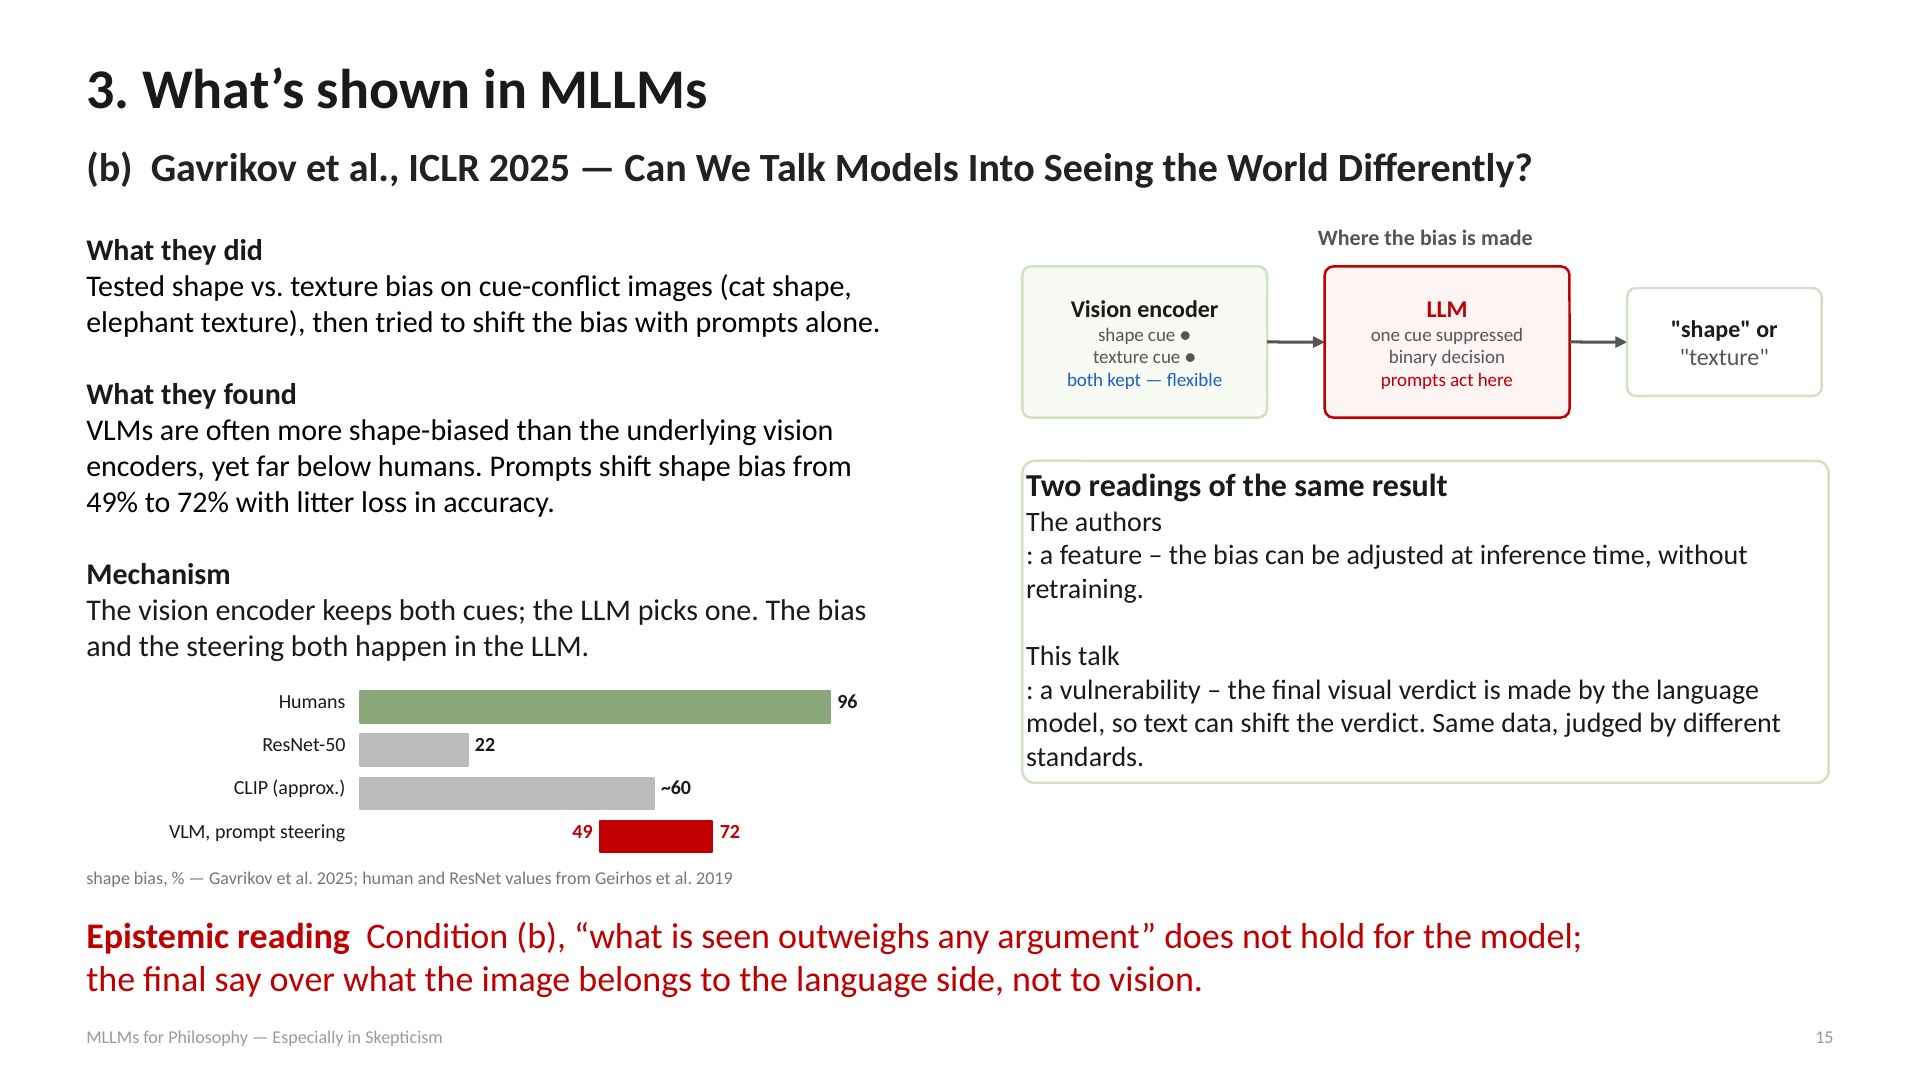
두 번째 논문은 Gavrikov et al.의 Can We Talk Models Into Seeing the World Differently?이다. 이 논문은 형태는 고양이인데 질감은 코끼리 가죽인 이미지처럼, 형태와 질감이 서로 다른 답을 가리키는 단서 충돌(cue-conflict) 이미지를 이용한다. 모델이 형태를 따라 답하는지, 질감을 따라 답하는지로 shape bias를 측정하고, 프롬프트만으로 이 편향을 움직여 보았다.
왼쪽 아래의 막대그래프를 보면, 사람의 형태 편향은 96%이고 ImageNet으로 학습한 ResNet-50은 22%, CLIP은 약 60% 수준이다. VLM은 대체로 안에 들어 있는 vision encoder보다는 형태 편향이 높지만, 사람과는 여전히 거리가 멀다. 그리고 프롬프트만 바꿔도 형태 편향이 49%에서 72%까지 움직이고, 그 과정에서 정확도는 거의 잃지 않는다.
오른쪽의 도식은 이 편향이 어디에서 만들어지는지를 보여준다. 논문의 분석(§4.2)에 따르면 vision encoder는 형태 단서와 질감 단서를 모두 갖고 있고, 그중 하나를 고르는 것은 LLM이다. 편향도, 편향의 조종도 모두 LLM에서 일어나는 것이다.
결국 조건 (b), “보이는 것이 어떤 논증보다 무겁다”는 조건은 이 모델에게 성립하지 않는다. 이미지가 무엇을 보여주는지에 대한 마지막 결정권이 시각이 아니라 언어 쪽에 있기 때문이다.
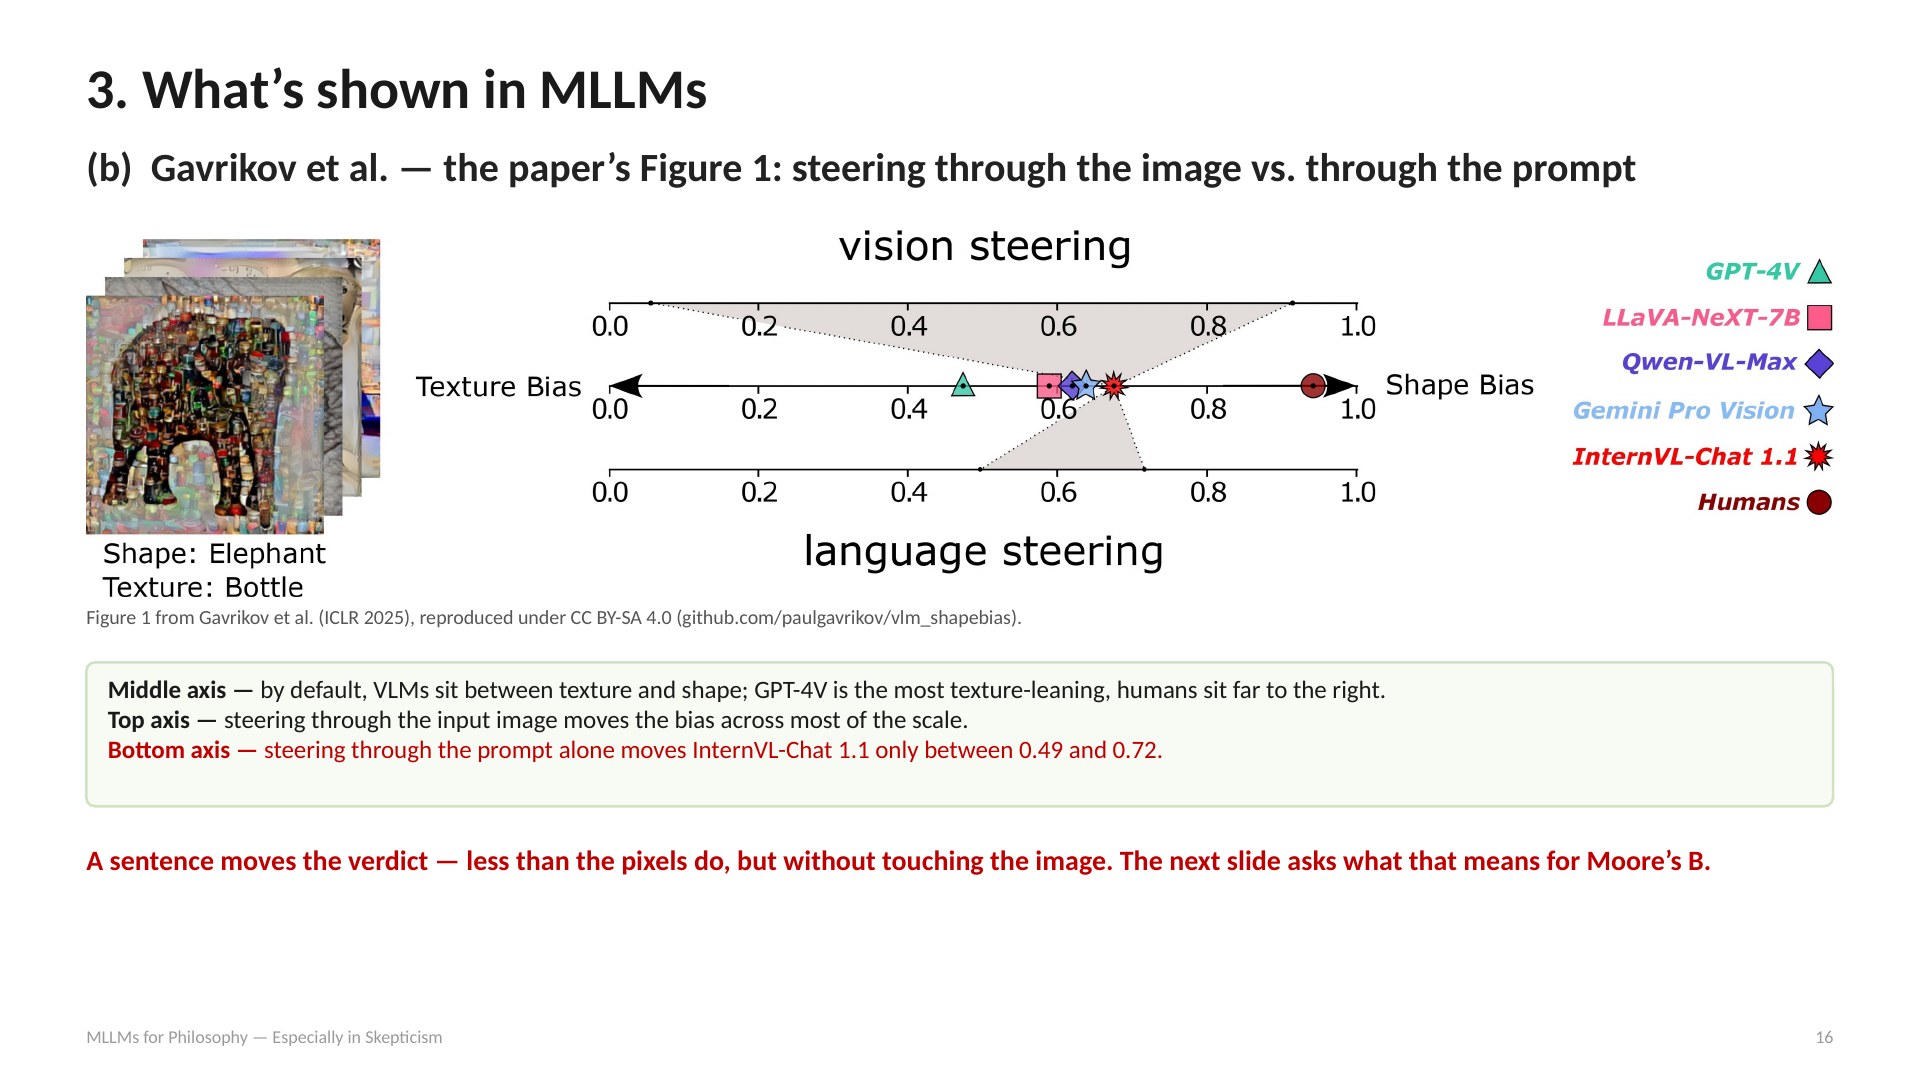
위 사진은 논문의 Figure 1이다. 가운데 축은 기본 상태의 형태 편향을 나타낸다. VLM들은 질감과 형태 사이에 분포하고, GPT-4V가 가장 질감 쪽에, 사람은 오른쪽 끝에 위치한다. 위 축은 입력 이미지를 바꿔서 조종한 결과로, 거의 전 구간을 움직인다. 아래 축은 프롬프트만으로 조종한 결과로, InternVL-Chat 1.1이 0.49에서 0.72 사이를 움직인다.
픽셀을 바꾸는 것만큼은 아니지만, 이미지를 전혀 건드리지 않고 문장 하나만으로 판정이 움직인다는 점이 중요하다.
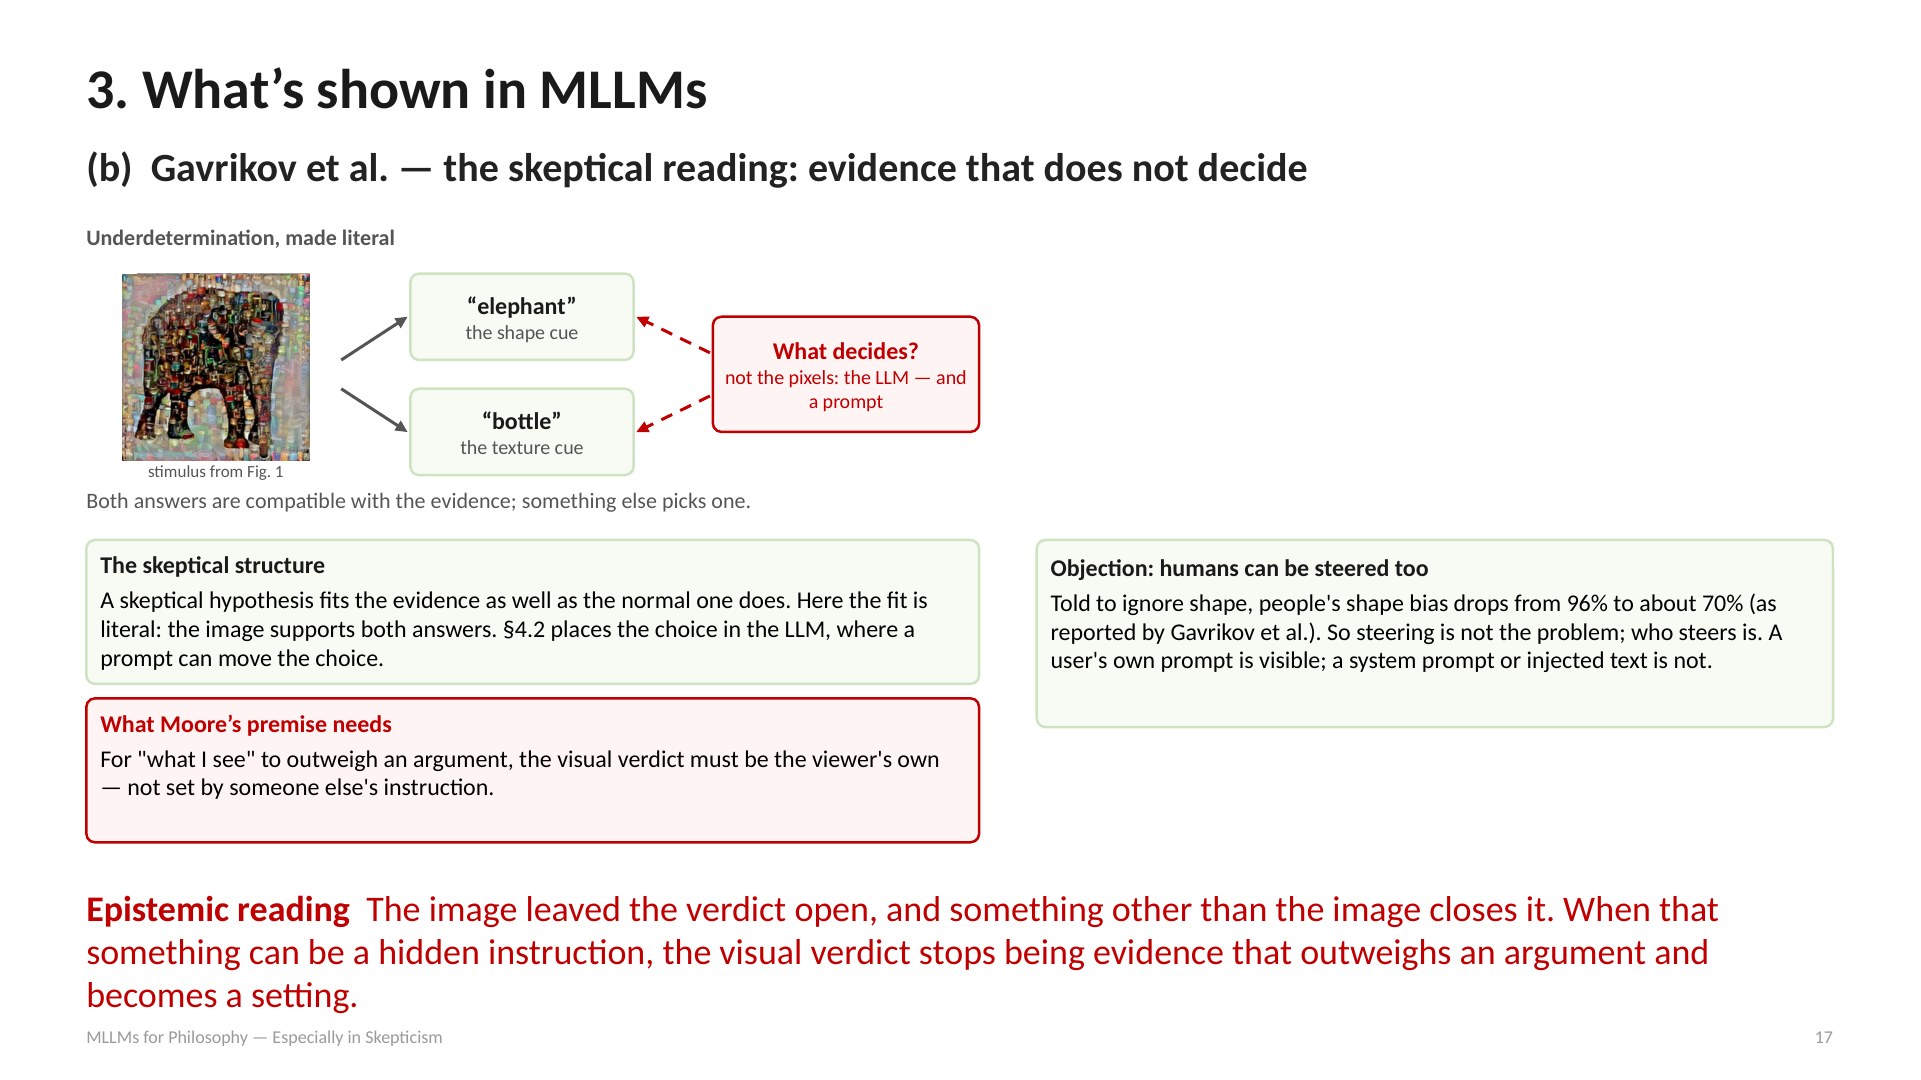
이제 이 결과를 인식론적 회의주의의 관점에서 읽어 보자. 왼쪽의 자극은 형태가 코끼리이고 질감이 병이다. 이 이미지는 “코끼리”라는 답과도, “병”이라는 답과도 양립한다. 철학에서 과소결정(underdetermination), 즉 증거가 결론을 정하지 못하는 상황이라고 부르는 현상이 발생한 것이다.
1부에서 회의적 가설의 두 번째 특징이 “증거와 완벽하게 양립한다”는 것이었다. 여기서는 그것이 비유가 아니다. 이미지가 두 답을 똑같이 지지하니 판정은 이미지 바깥에서 와야 하고, 논문의 §4.2는 그 선택이 LLM에서 이루어지며 프롬프트가 그 선택을 움직인다는 것을 보여준다.
Moore의 전제가 성립하려면, 즉 “내가 보는 것”이 논증보다 무거우려면 시각 판정은 보는 이 자신의 것이어야 한다. 다른 누군가의 지시로 정해진 것이어서는 안 된다. 이미지가 판정을 열어 두고 이미지가 아닌 무언가가 그것을 닫는데, 그 무언가가 숨은 지시일 수 있다면 시각 판정은 논증보다 무거운 증거이기를 멈추고 하나의 설정값이 된다.
3-3. Bowers et al. (BBS 2023) : 알아볼 수 없는 가짜, 구별하지 못하는 점수
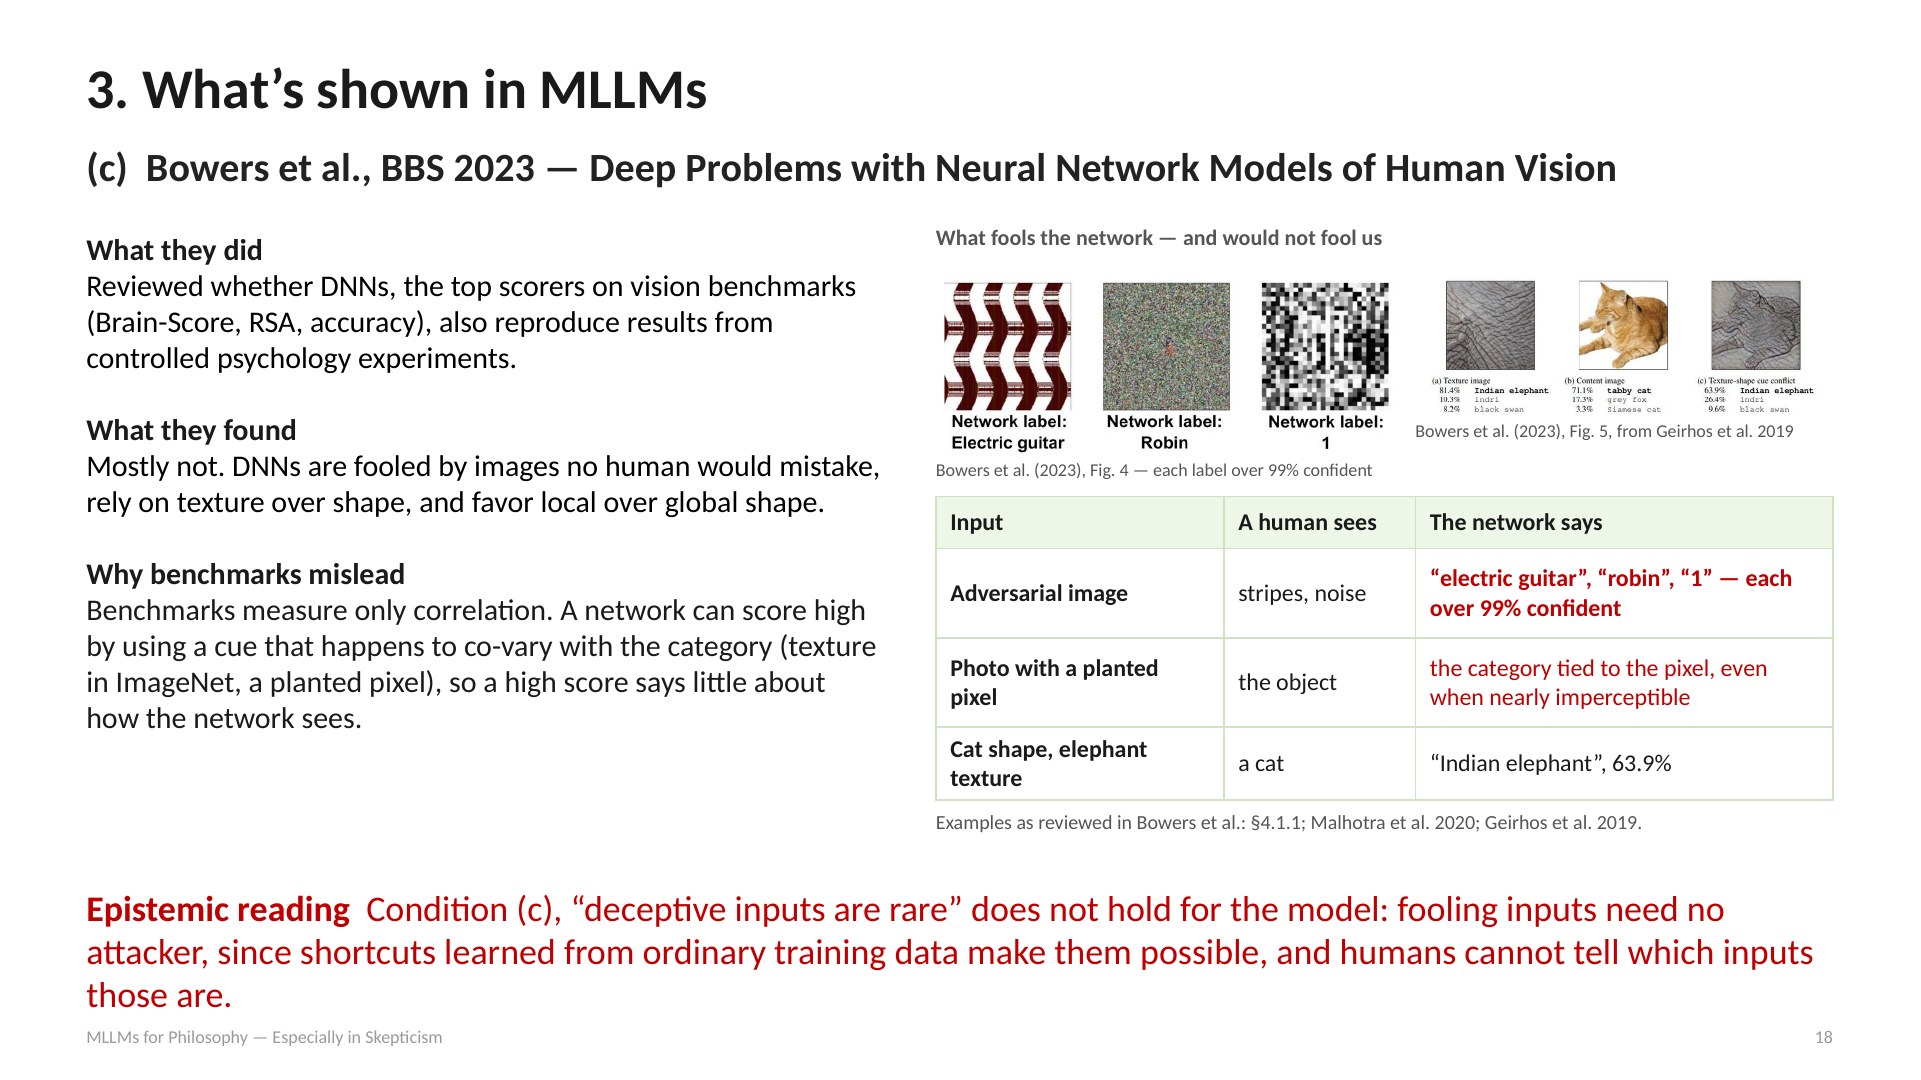
세 번째 논문은 Behavioral and Brain Sciences에 실린 Bowers et al.의 Deep Problems with Neural Network Models of Human Vision이다. 앞의 두 논문과 달리 새로운 실험을 한 논문이 아니라 기존 연구를 검토한 리뷰 논문이다. 이 논문은 Brain-Score, RSA, 정확도와 같은 벤치마크에서 최고 점수를 받는 DNN이 통제된 심리학 실험의 결과도 재현하는지를 검토하였다.
대답은 “대부분 아니다”이다. DNN은 사람이라면 절대 착각하지 않을 이미지에 속고, 형태보다 질감에 의존하며, 전역적인 형태보다 국소적인 형태를 따른다. 이 논문은 벤치마크가 왜 우리를 오도하는지도 설명한다. 벤치마크는 상관만 측정하기 때문에, 네트워크가 ImageNet의 질감이나 일부러 심어 둔 픽셀처럼 범주와 우연히 함께 변하는 단서만 이용해도 높은 점수를 받을 수 있다. 따라서 높은 점수는 네트워크가 어떻게 보는지에 대해 별로 말해주지 않는다.
오른쪽 아래의 표를 한 줄씩 보자. 사람의 눈에는 줄무늬와 잡음으로 보이는 이미지에 네트워크는 “일렉트릭 기타”, “울새”, “1”이라고 각각 99%가 넘는 확신으로 답한다. 거의 보이지 않는 픽셀 하나를 심어 두면, 네트워크는 물체가 아니라 그 픽셀에 묶인 범주로 분류한다. 형태는 고양이이고 질감은 코끼리인 이미지에는 “인도코끼리”라고 63.9%의 확신으로 답한다. 다만 이 사례들은 MLLM이 아니라 이미지 분류기에서 나온 결과라는 점은 밝혀 둔다.
결국 조건 (c), “속이는 입력은 드물다”는 조건은 이 모델에게 성립하지 않는다. 모델을 속이는 입력에는 공격자가 필요 없다. 평범한 학습 데이터에서 배운 지름길이 그런 입력을 가능하게 하고, 우리는 어떤 입력이 그런 입력인지 알아볼 수 없다.
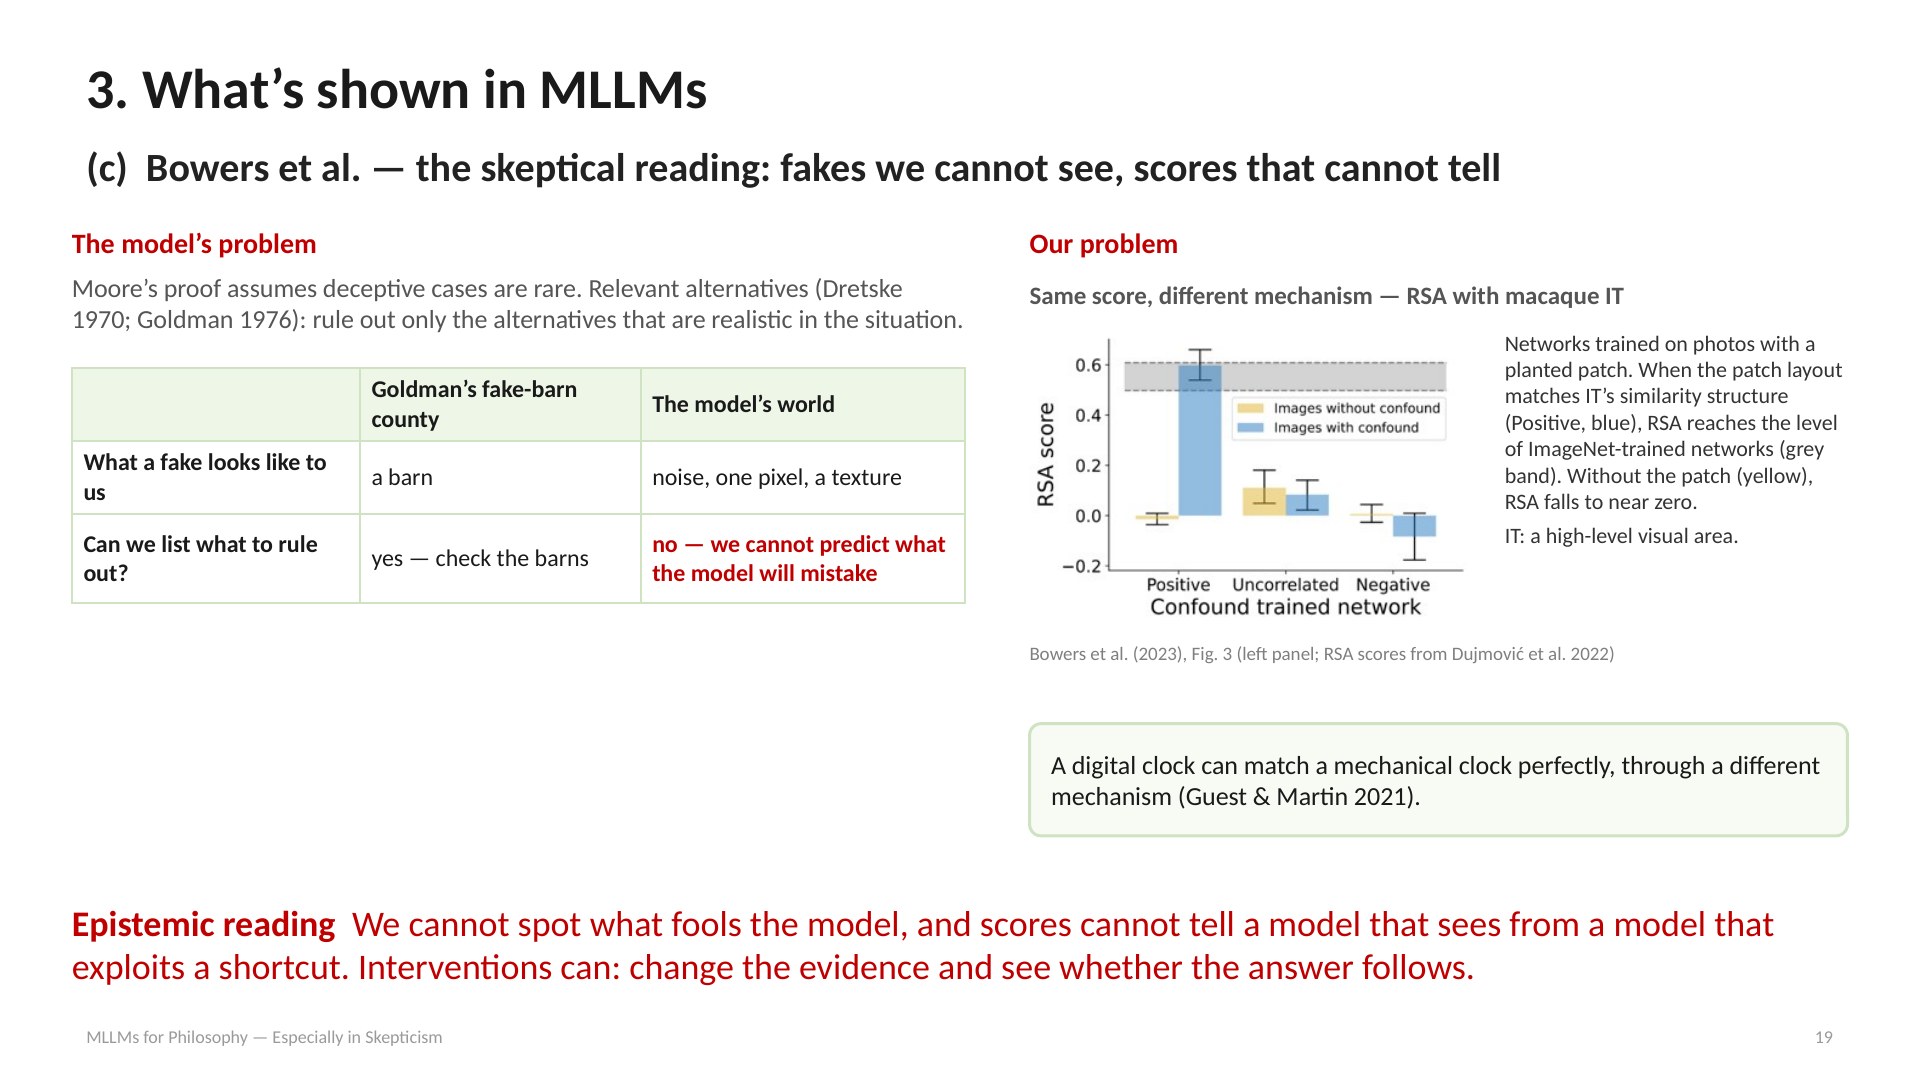
이 논문을 회의주의적으로 읽으면 두 가지 문제가 나온다. 슬라이드 왼쪽은 모델의 문제이고, 오른쪽은 우리의 문제이다.
먼저 모델의 문제이다. Moore의 증명에는 평범한 상황에서 우리 눈이 속는 일은 드물다는 전제가 깔려 있다. 하지만 Goldman의 유명한 예시인 가짜 헛간 마을을 통해 우리의 눈이 속는 일은 떠올려 볼 수 있다.
길가에 판자로 만든 가짜 헛간이 가득한 마을에서는 진짜 헛간을 보고 있더라도 “저것은 헛간이다”라고 안다고 말하기 어렵다. 그래도 그 마을의 가짜는 우리 눈에 헛간처럼 생겼기 때문에, 가서 확인해 보면 된다. 즉 무엇을 배제해야 하는지 목록을 쓸 수 있다.
하지만 MLLM에게 가짜는 우리 눈에 잡음, 픽셀 하나, 질감으로 보인다. 모델이 무엇을 착각할지 우리가 예측할 수 없으니, 모델 대신 배제할 목록을 쓸 수도 없다.
다음은 우리의 문제이다. 오른쪽 그래프는 Bowers et al.이 인용한 Dujmović et al.의 결과이다. 사진에 패치를 심어서 학습시킨 네트워크도, 패치의 배치가 원숭이 IT 피질(고차 시각 영역)의 유사도 구조와 맞으면 RSA 점수가 ImageNet으로 학습한 네트워크 수준까지 올라간다. 그런데 패치를 빼면 점수는 0 근처로 떨어진다. 이 네트워크는 물체가 아니라 패치를 읽고 있었던 것이다. Guest & Martin의 비유처럼, 디지털 시계는 기계식 시계와 완벽하게 같은 시간을 가리킬 수 있지만 그 메커니즘은 전혀 다르다.
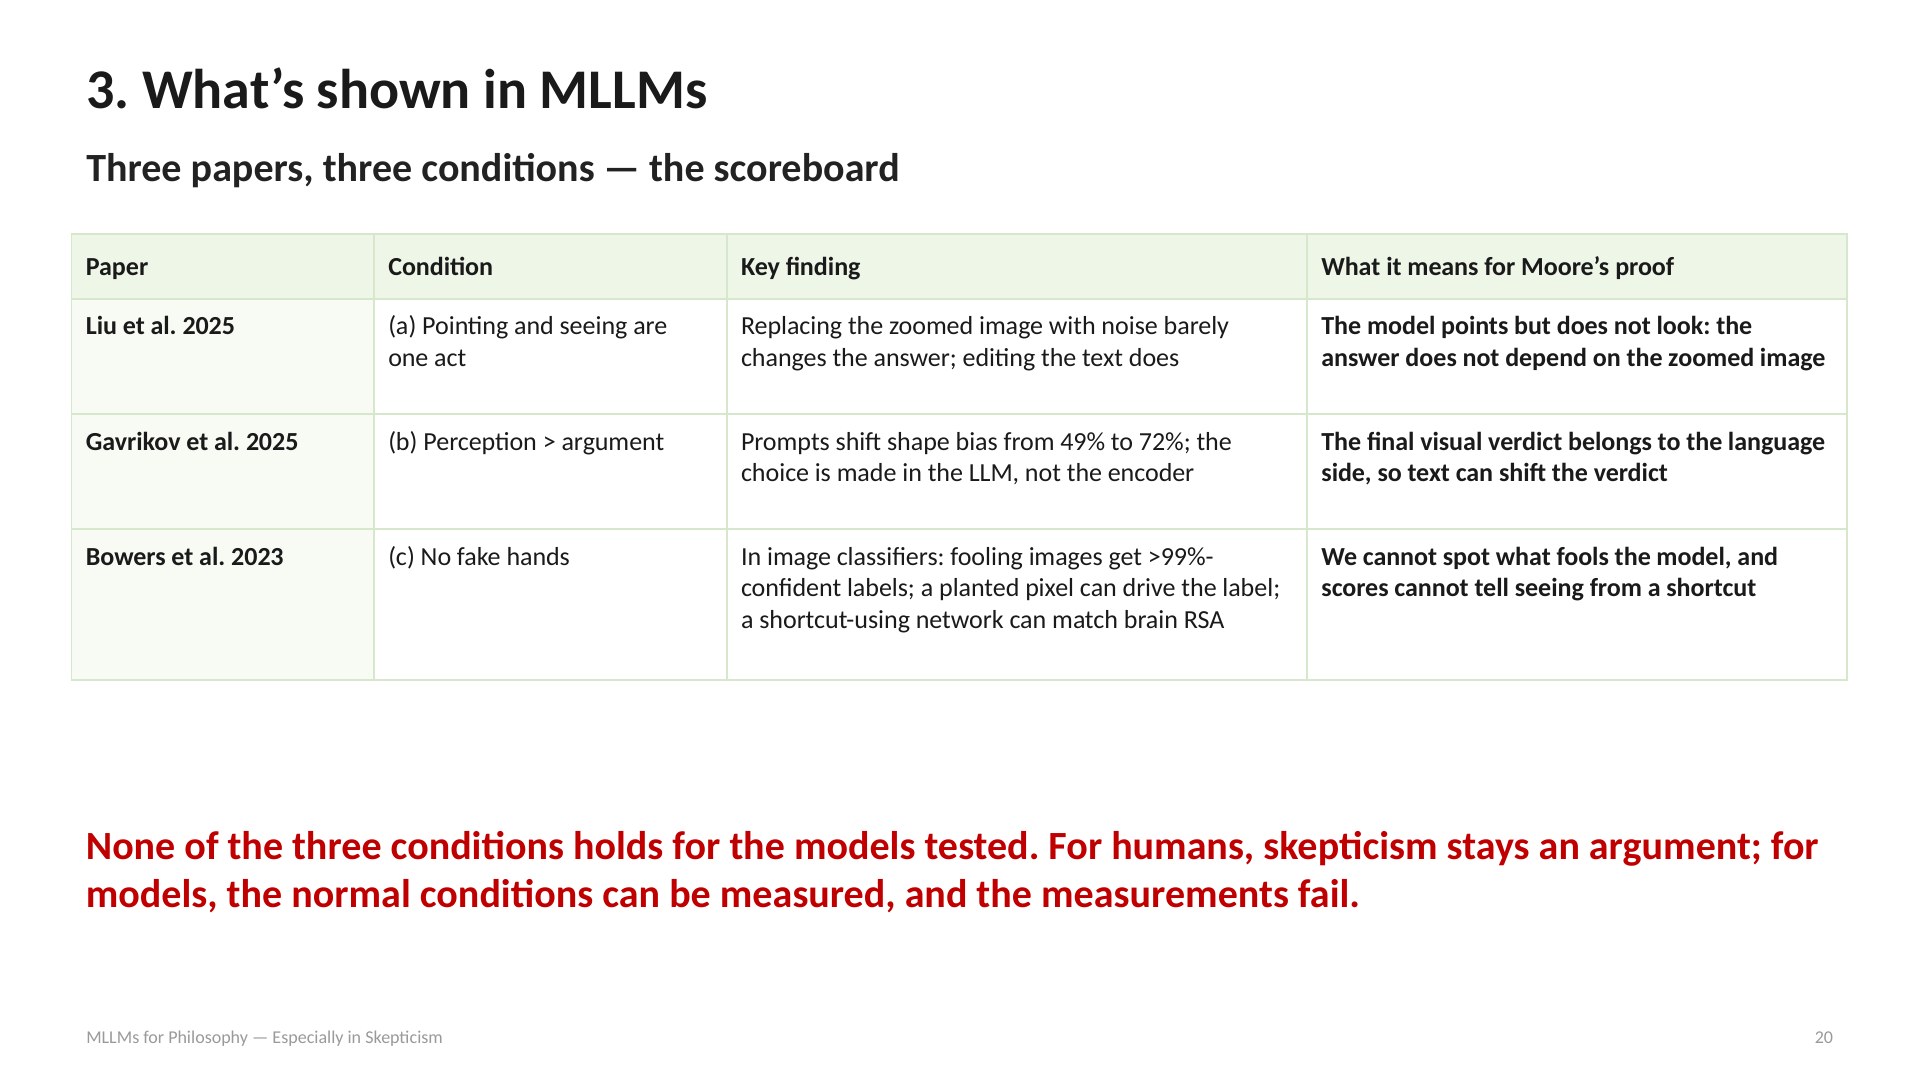
세 논문을 하나의 표로 모으면 위 사진과 같다.
- Liu et al.의 모델은 가리키지만 보지 않으므로 조건 (a)가 깨진다.
- Gavrikov et al.에서는 최종 시각 판정이 언어 쪽에 있어서 텍스트가 판정을 움직이므로 조건 (b)가 깨진다.
- Bowers et al.에서는 무엇이 모델을 속이는지 우리가 알아볼 수 없고, 점수로는 보는 것과 지름길을 구별할 수 없으므로 조건 (c)가 깨진다.
3부의 결론은 검사된 모델들에게 세 조건 중 어느 것도 성립하지 않는다는 것이다. 사람에게 회의주의는 끝내 논증으로 남지만, 모델에게는 정상 조건을 측정할 수 있고, 그 측정은 실패로 나온다.
4. Nevertheless
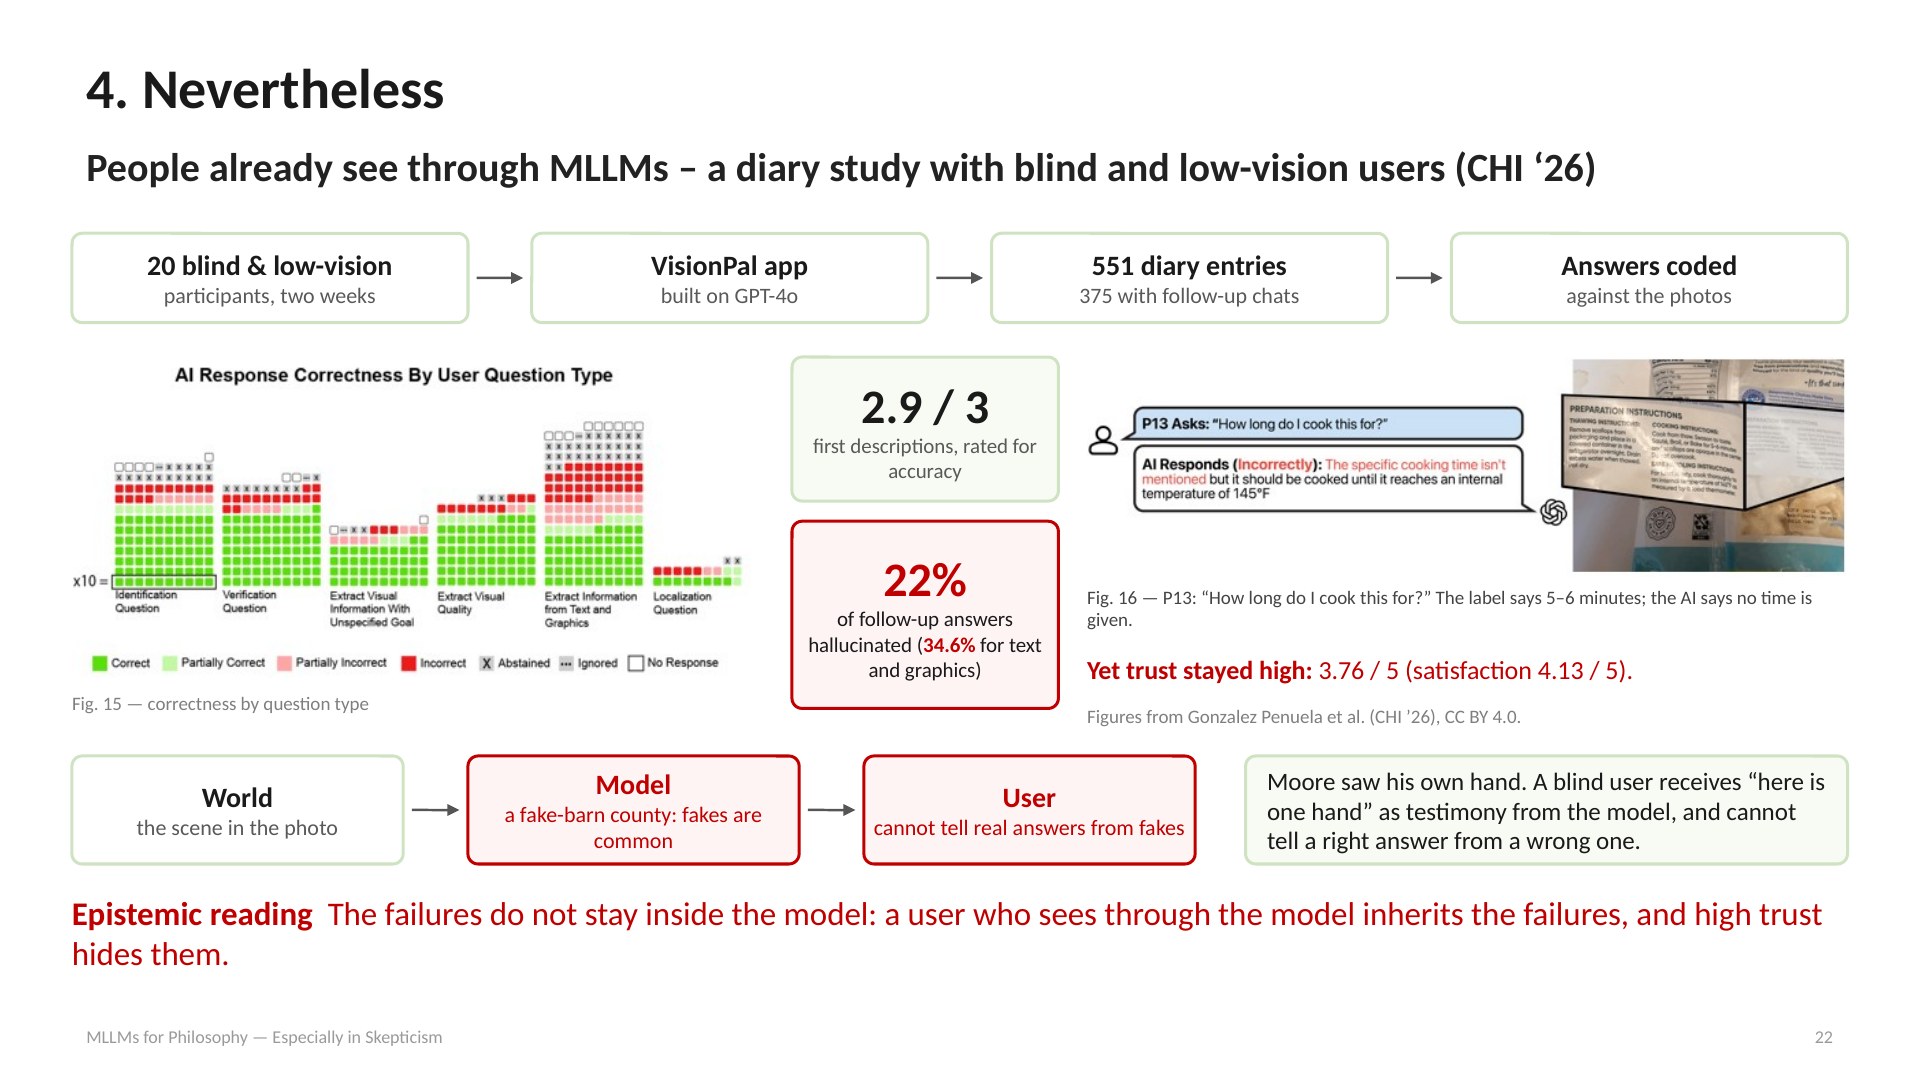
앞의 세 논문이 보여준 한계에도 불구하고, 이미 일상에서 멀티모달 모델에 시각 정보를 의존하는 사용자들이 있다. 위 슬라이드는 CHI ‘26에 실린 시각장애·저시력 사용자의 일기 연구이다. 참여자 20명이 2주 동안 GPT-4o 기반의 VisionPal 앱을 사용했고, 일기 551건이 모였으며 그중 375건에는 후속 대화가 남았다. 연구자들은 모델의 답을 실제 사진과 대조하여 채점하였다. 참여자 수와 기간, 그리고 하나의 앱이라는 조건을 생각하면 이 결과를 모든 사용자에게 일반화하기는 어렵지만, 실제 사용 환경에서 수집된 자료라는 점에서 의미가 있다고 생각한다.
이 연구에서 첫 서술의 정확도 평가는 3점 만점에 2.9점이었다. 반면 후속 질문에 대한 답의 22%에서 환각이 확인되었고, 글자와 그래픽을 읽는 질문에서는 그 비율이 34.6%였다. 왼쪽의 그림 15에서도 글자·그래픽에서 정보를 추출하는 질문 유형에 붉은 칸, 즉 오답이 상대적으로 많은 것을 볼 수 있다.
오른쪽의 그림 16은 논문에 실린 사례 중 하나이다. 한 참여자가 “이거 얼마나 익혀야 해?”라고 묻는다. 포장에는 5–6분이라고 적혀 있는데, 모델은 조리 시간이 나와 있지 않다고 답한다. 화면을 볼 수 없는 사용자는 이런 오류를 그 자리에서 알아차리기 어렵다. 한편 연구 기간 동안 사용자들의 신뢰도는 5점 만점에 3.76점, 만족도는 4.13점으로 꽤 높은 편이였다.
여기서부터는 나의 해석이다. Moore는 자기 손을 직접 보았지만, 시각장애인 사용자는 “여기 한 손이 있다”를 모델의 증언(testimony)으로 받는다. 22%라는 수치를 Goldman의 가짜 헛간 마을에 그대로 대응시킬 수는 없지만, 사용자가 어떤 답이 틀렸는지 스스로 확인하기 어렵다는 점에서 두 상황의 구조는 닮아 있다. 그래서 나는 3부에서 본 모델의 실패가 모델 안에만 머물지 않고, 모델을 통해 보는 사용자에게까지 이어질 수 있다고 제안한다. 비교적 높은 신뢰도는 그런 실패를 드러나기 어렵게 만들 수도 있다. 다만 이것은 연구 결과에 내가 덧붙인 해석이다.
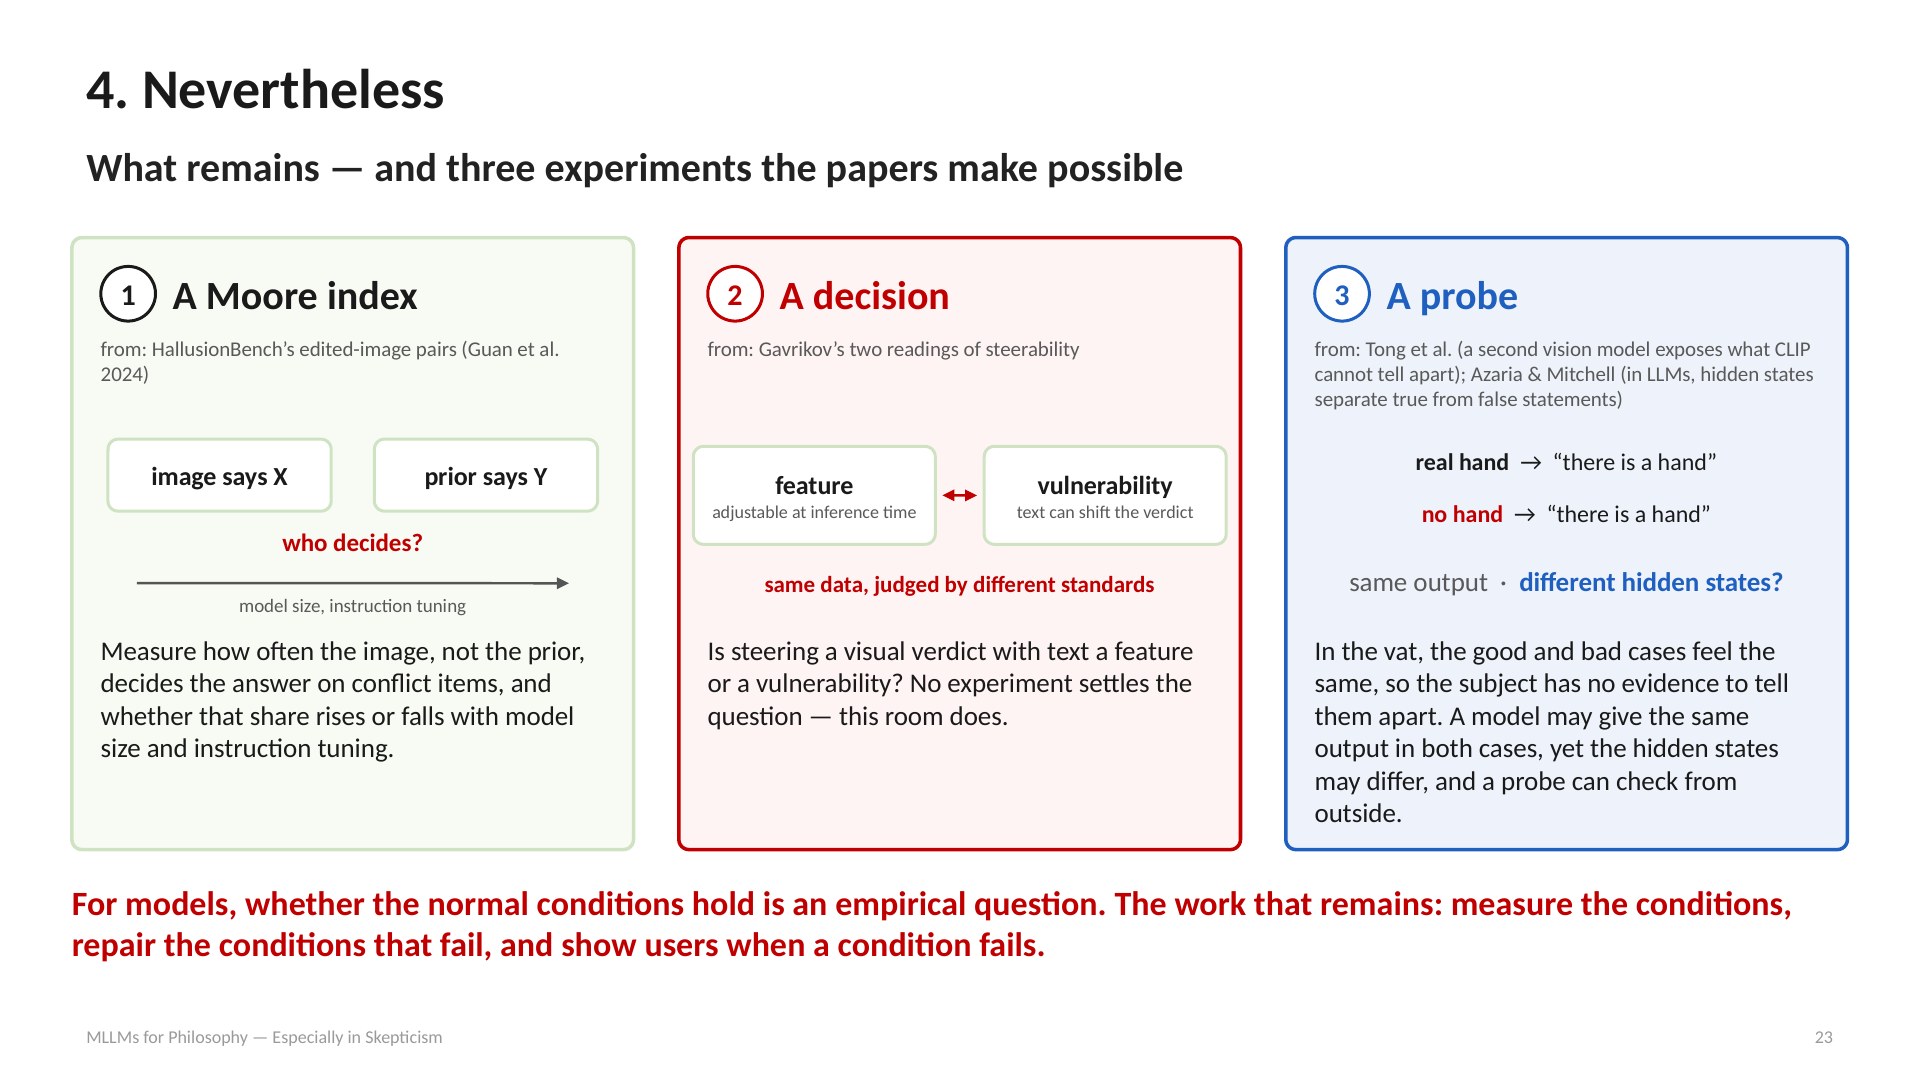
마지막 슬라이드에서는 이 논문들을 바탕으로 해 볼 수 있는 세 가지를 제안했다. 셋 모두 아직 수행된 연구가 아니라 발표에서 제시한 제안이다.
첫 번째는 Moore index이다. HallusionBench처럼 유명한 원본 이미지와 편집된 이미지를 짝지은 문항에서는 이미지와 prior가 서로 다른 답을 가리킨다. 이런 충돌 문항에서 prior가 아니라 이미지가 답을 정하는 비율을 측정하고, 그 비율이 모델 크기와 instruction tuning에 따라 어떻게 달라지는지 추적해 보자는 것이다. 모델이 커질수록 이미지를 더 따르게 될지, prior에 더 기울게 될지는 아직 알 수 없다.
두 번째는 실험이 아니라 결정이다. 텍스트로 시각 판정을 조종할 수 있다는 것은 기능일까, 취약성일까? Gavrikov et al.을 두고 본 두 가지 독해이다. 같은 데이터를 두고 판단의 기준이 다르기 때문에, 실험만으로는 이 질문에 답하기 어렵다. 그래서 이 질문은 발표를 듣는 청중과 함께 생각해 볼 문제로 남겨 두었다.
세 번째는 프로브(probe)이다. 손이 있을 때도, 손이 없을 때도 모델은 “손이 있다”고 출력할 수 있다. 출력은 같지만, 그 아래의 은닉 상태도 같을까? 통 속의 뇌는 좋은 경우와 나쁜 경우가 똑같이 느껴지기 때문에 둘을 구별할 증거가 없었다. 반면 모델에는 출력 아래에 은닉 상태가 있으므로, 프로브를 통해 바깥에서 그 차이를 확인해 볼 여지가 있다. 다만 프로브가 멀티모달 모델의 시각적 판단에서 실제로 그 차이를 잡아낼 수 있을지는 아직 열린 질문이다.
정리하면, 멀티모달 언어모델을 통해 논증으로 그쳤던 정상 조건이 성립하는지는 시뮬레이션을 할 수 있는 새로운 국면이 펼쳐졌다. 남은 일은 그 조건을 측정하고, 실패한 조건을 고치고, 조건이 실패할 때 사용자에게 보여주는 것이다. 사람에게 회의주의는 2,400년 동안 논증으로 남아 있었다. 그렇다면 모델의 정상 조건을 측정하고 고칠 수 있게 되었을 때, 우리는 모델의 눈을 통해서도 “여기 한 손이 있다”고 말할 수 있게 될까?
발표에서 참고한 문헌들은 위와 같다.